Projektberichte
Um den Projektstatus anzuzeigen, die Effektivität von Methoden der automatischen Übersetzung zu bewerten, Übersetzungskosten zu schätzen und zu zählen, die aktivsten Mitglieder im Blick zu behalten und historische Daten zuvor erstellter Berichte anzuzeigen, öffne dein Projekt und gehe zum Tab Berichte.
Verwende diesen Bereich, um eine umfassende Zusammenfassung des Projektzustands zu erhalten, wichtige Aktivitäten zu überwachen und den Fortschritt über ausgewählte Zeiträume hinweg zu verfolgen. Oben rechts kannst du eine Berichtseinheit (Wörter, Zeichenfolgen, Zeichen oder Zeichen mit Leerzeichen) auswählen, die für alle Berichte in diesem Bereich gilt. Die prozentual angezeigten Vergleiche werden berechnet, indem der ausgewählte Zeitraum mit demselben vorherigen Zeitraum verglichen wird (z. B. wird bei Auswahl eines Monats der aktuelle Monat mit dem vorherigen verglichen).
Um Berichte zur weiteren Analyse oder Dokumentation herunterzuladen, klicke auf Exportieren und wähle das gewünschte Format (CSV, XLSX oder JSON).
In Berichten mit interaktiven Diagrammen kannst du den Mauszeiger über Datenpunkte bewegen, um detailliertere Informationen wie Tages- oder Monatssummen für jede Kategorie anzuzeigen.
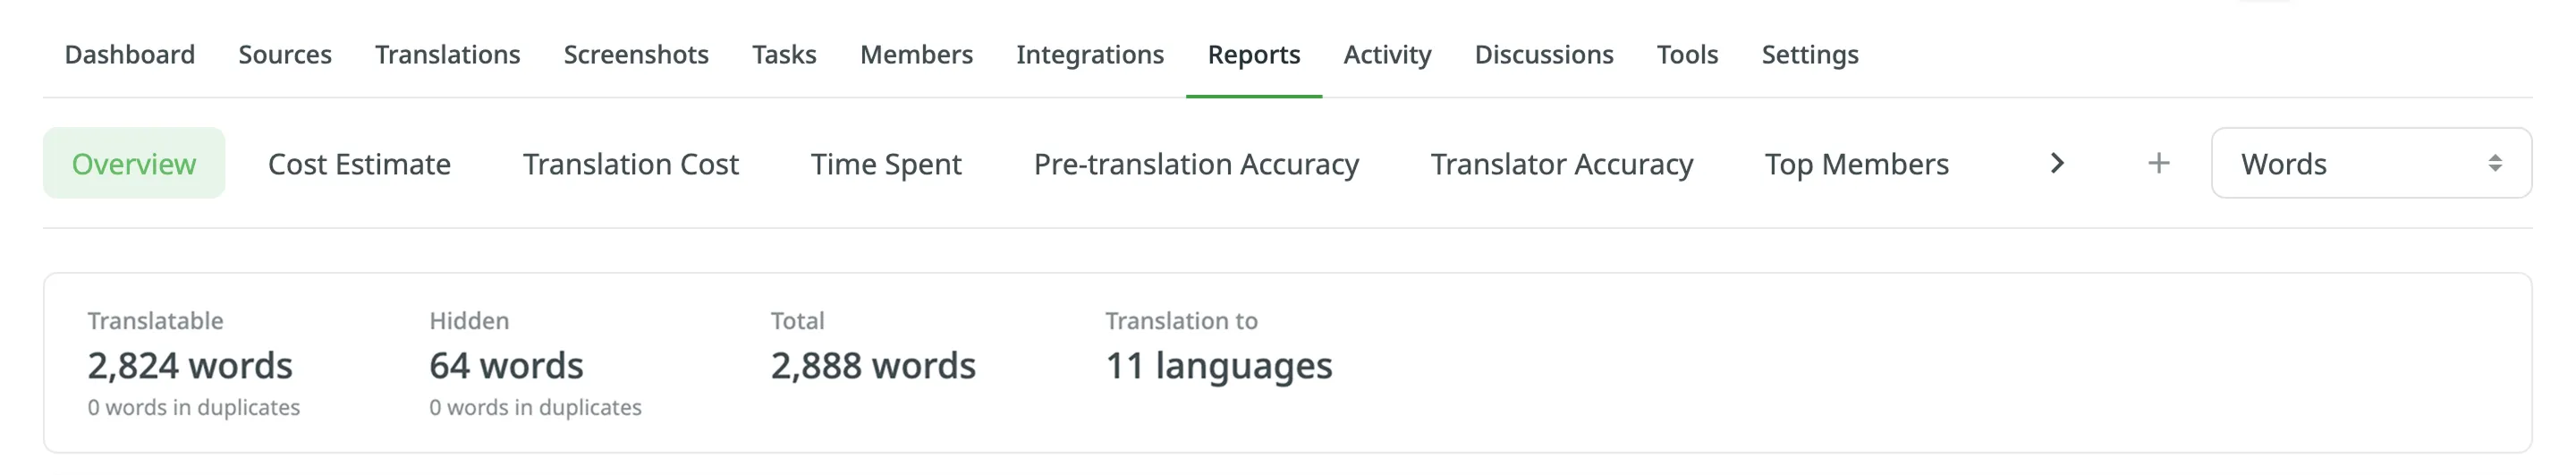
Oben auf der Seite werden die wichtigsten Statistiken zum Umfang deines Projekts angezeigt:
- Übersetzbar: Die Gesamtmenge des für die Übersetzung verfügbaren Textes.
- Ausgeblendet: Die Gesamtmenge des Textes in ausgeblendeten Zeichenfolgen.
- Gesamt: Die Gesamtmenge des Textes im Projekt (Übersetzbar + Ausgeblendet).
- Übersetzung in: Die Anzahl der Zielsprachen im Projekt.
Unter den Hauptstatistiken enthält der Bereich Übersicht die folgenden Berichte:
Dieser Bericht verfolgt die gesamte Übersetzungs- und Korrekturleseaktivität im Projekt. Du kannst die Daten nach Datumsbereich, Sprache und Mitglied filtern. Der Bericht ist in zwei Hauptbereiche unterteilt: Übersetzung und Korrekturlesen.
Jeder Bereich zeigt die insgesamt im ausgewählten Zeitraum geleistete Arbeit mit einem prozentualen Vergleich zum vorherigen Zeitraum. Du kannst in jedem Bereich den Abschnitt Aufschlüsselung nach Sprache erweitern, um eine Tabelle mit denselben Kennzahlen, aufgeschlüsselt nach Zielsprache, anzuzeigen.
Dieser Bereich zeigt den Umfang des übersetzten Textes, aufgeschlüsselt nach den folgenden wichtigen Kennzahlen:
- Gesamt (Ende des Zeitraums)
- Menschliche Übersetzung
- Translation Memory
- Machine Translation
- KI
Das Diagramm Übersetzung unter den Kennzahlen zeigt für jeden Übersetzungstyp mehrere Linien gleichzeitig. Wenn du den Mauszeiger über Datenpunkte bewegst, kannst du Tages- oder Monatssummen für jede Kategorie anzeigen.
Dieser Bereich zeigt den Umfang des genehmigten Textes und die Abstimmungsaktivität. Die wichtigste Kennzahl ist Genehmigte Wörter.
Das Diagramm Korrekturlesen visualisiert die Genehmigungs- und Abstimmungsaktivität im Zeitverlauf anhand zweier unterschiedlicher Linien: Genehmigte Wörter und Stimmen. Wenn du den Mauszeiger über Datenpunkte bewegst, kannst du die Tages- oder Monatssummen für genehmigte Texte und abgegebene Stimmen anzeigen.
Zusammenfassung der Übersetzungseinsparungen
Abschnitt betitelt „Zusammenfassung der Übersetzungseinsparungen“Verwende diesen Bericht, um die durch Translation Memory (TM), Machine Translation (MT) und künstliche Intelligenz (KI) erzielten Einsparungen zu prüfen.
Du kannst die Daten nach Datumsbereich, Sprache, Mitglied und Dateien oder Branches filtern, je nach Projekttyp. Wenn du auf den Filter Dateien/Branches klickst, wird ein Dialog mit zwei Optionen geöffnet: Alle Dateien/Branches (standardmäßig ausgewählt) und Ausgewählte Dateien/Branches. Wenn du Ausgewählte Dateien/Branches auswählst, wird im Dialog ein Dateibaum angezeigt, in dem du deine Auswahl durchsuchen und anpassen kannst. Klicke anschließend auf Speichern, um zu bestätigen. Der Bericht verwendet eine Tarifvorlage, um Einsparungen zu berechnen. Standardmäßig wird das Standardschema für Nettotarife verwendet, du kannst aber eine benutzerdefinierte Vorlage auswählen, um bestimmte Vereinbarungen abzubilden.
Über das Dropdown-Menü Modus kannst du zwischen der Anzeige der Daten als % (Prozentsatz) oder Währung wechseln.
Im Bereich Übersetzungseinsparungen werden die Gesamteinsparungen für den ausgewählten Zeitraum als Prozentsatz oder Währungsbetrag angezeigt, zusammen mit einer Aufschlüsselung der Einsparungen aus Translation Memory, Machine Translation und KI.
Das darunterliegende Balkendiagramm visualisiert diese Einsparungen im Zeitverlauf. Einsparungen werden für jede Zeichenfolge nur einmal berechnet, und zwar beim ersten manuellen Beitrag (einer neuen Übersetzung oder einer Genehmigung). Dazu gehört auch die Genehmigung einer Übersetzung, die aus einer automatischen Übersetzung stammt (in diesem Fall wird die Einsparung dem Datum und der Methode der automatischen Übersetzung zugeordnet).
Wenn für eine Zeichenfolge eine Kombination aus TM- und MT-/KI-Vorschlägen verfügbar ist, wird der neue Beitrag der Kategorie mit dem höchsten potenziellen Einsparungswert zugeordnet.
Wenn du den Mauszeiger über die Balken bewegst, werden detaillierte Informationen zu den Einsparungen je Methode auf Tages- oder Monatsbasis angezeigt. Für eine detailliertere Ansicht kannst du außerdem den Bereich Aufschlüsselung nach Sprache erweitern, um eine Tabelle mit Einsparungen für jede einzelne Sprache anzuzeigen.
Das Standardschema für Nettotarife ist die standardmäßig integrierte Vorlage, die zur Berechnung verwendet wird, wenn keine benutzerdefinierte Vorlage ausgewählt wurde. Dieses Schema definiert Einsparungen auf Grundlage eines gestaffelten „Nettotarif“-Modells, das Industriestandards widerspiegelt, bei denen nicht jede Übereinstimmung denselben Wert hat.
Ein unscharfer Treffer mit niedrigem Prozentsatz (z. B. unter 75 %) wird beispielsweise häufig von einem Übersetzer vollständig überarbeitet. Daher betrachtet dieses Schema solche Übereinstimmungen als 0 % Einsparung, auch wenn ein Treffer vorgeschlagen wurde.
Das Standardschema ist in zwei Kategorien unterteilt, jeweils mit eigenen Tarifen:
Einsparungstarife: TM
| Treffertyp | Nettotarif | Einsparung |
|---|---|---|
| Perfekte Übereinstimmung / Genehmigung ohne Änderungen | 5 % | 95 % |
| 100 % / Genehmigung ohne Änderungen | 15% | 85 % |
| Unscharfer Treffer 95–99 % | 35 % | 65 % |
| Unscharfer Treffer 85–94 % | 55 % | 45 % |
| Unscharfer Treffer 75–84 % | 75 % | 25 % |
| Unscharfer Treffer < 75 % | 100 % | 0 % |
Einsparungstarife: MT / KI
| Treffertyp | Nettotarif | Einsparung |
|---|---|---|
| Genehmigung ohne Änderungen | 10 % | 90 % |
| 99–90 % | 30 % | 70 % |
| 89–70 % | 50 % | 50 % |
| 69–50 % | 75 % | 25 % |
| < 50 % | 100 % | 0 % |
Hier sind einige Beispiele dafür, wie Einsparungen anhand dieser Standardtarife berechnet werden:
- TM-Beispiel: Eine 10-Wörter-Zeichenfolge wird mithilfe eines 95–99-%-Fuzzy-Treffers aus deinem TM übersetzt. Laut Tabelle hat dieser Treffertyp eine Einsparung von 65 %. Daher zählt der Bericht 6,5 Wörter (10 Wörter * 65 %) als eingespart.
- MT-/KI-Beispiel (Genehmigung): Ein String mit 10 Wörtern wird von einer MT-Engine automatisch übersetzt. Ein Korrekturleser prüft und genehmigt sie, ohne Änderungen vorzunehmen. Diese Aktion fällt in die Kategorie Genehmigung ohne Änderungen, die eine Einsparung von 90 % aufweist. Der Bericht zählt 9 Wörter (10 Wörter * 90 %) als eingespart.
- MT-/KI-Beispiel (Manuelle Bearbeitung): Für eine 10-Wörter-Zeichenfolge liegt ein MT-Vorschlag vor. Ein Übersetzer bearbeitet den Vorschlag (oder schreibt seine eigene Übersetzung). Das System vergleicht die letztlich gespeicherte Übersetzung des Übersetzers mit dem ursprünglichen MT-Vorschlag und stellt fest, dass sie zu 80 % ähnlich sind. Diese Aktion fällt in die Trefferkategorie 89–70 %, die eine Einsparung von 50 % aufweist. Der Bericht zählt 5 Wörter (10 Wörter * 50 %) als eingespart.
- Beispiel ohne Einsparung: Eine 10-Wörter-Zeichenfolge weist einen Fuzzy-Treffer < 75 % auf. Laut TM-Tabelle ergibt dies eine Einsparung von 0 %. Obwohl ein Treffer vorlag, wird er im Bericht nicht als Einsparung gezählt, da wahrscheinlich eine vollständige Neuübersetzung erforderlich war.
Dieser Bericht verfolgt Änderungen am Quellinhalt über einen ausgewählten Zeitraum. Du kannst die Daten nach Datumsbereich filtern. Der Bericht zeigt das Volumen Gesamt (Ende des Zeitraums) des Textes sowie spezifische Kennzahlen für Inhalte, die hinzugefügt, gelöscht oder geändert wurden.
Das Balkendiagramm hilft dir, die Zeitpunkte der wichtigsten Inhaltsaktualisierungen zu visualisieren. Wenn du den Mauszeiger über die Balken bewegst, kannst du die an jedem Tag oder in jedem Monat vorgenommenen spezifischen Änderungen sehen.
Dieser Bericht bietet Einblicke in die automatisierten Qualitätssicherungsprüfungen (QA) und hebt mögliche Inkonsistenzen in Übersetzungen hervor. Du kannst die Daten nach Datumsbereich und Sprache filtern.
Zu den wichtigsten Kennzahlen gehören:
- Neu (Zeitraum): Die Anzahl der im ausgewählten Zeitraum neu gefundenen QA-Probleme.
- Gesamt (Ende des Zeitraums): Die Gesamtzahl der am Ende des ausgewählten Zeitraums ungelösten QA-Probleme.
- Pro 1.000 Wörter: Die Dichte der QA-Probleme im Verhältnis zur Wortanzahl. Diese Kennzahl umfasst genehmigte Inhalte und wird nur angezeigt, wenn die Gesamtwortzahl größer als 1.000 ist.
- Inhalte mit Problemen: Der Umfang des Textes, der QA-Probleme enthält, einschließlich genehmigter Inhalte.
- Rate der Inhalte mit Problemen: Der Prozentsatz des Textes, der QA-Probleme enthält, einschließlich genehmigter Inhalte.
Unter den Kennzahlen enthält der Bericht außerdem mehrere zusätzliche Komponenten:
- Aufschlüsselung nach Sprache: Ein ausklappbarer Bereich mit einer Tabelle der wichtigsten Kennzahlen, aufgeschlüsselt nach Zielsprache.
- Trend der Probleme: Ein Liniendiagramm, das die Gesamtzahl der QA-Probleme im Zeitverlauf überwacht. Du kannst die Daten nach Datumsbereich und Problemtyp filtern.
- Die wichtigsten Kennzahlen zeigen Gesamt, Erstellt und Behoben sowie jeweils einen Vergleich mit dem vorherigen Zeitraum. Dieser Bericht besteht aus den folgenden Komponenten:
Probleme nach Typ: Eine Tabelle mit den Gesamt-, Erstellungs- und Behebungszahlen für jede Problemkategorie (z. B. Allgemeine Frage, Aktuelle Übersetzung ist falsch). Falsche Übersetzungen nach Sprache: Eine Tabelle, die sich auf den Problemtyp Aktuelle Übersetzung ist falsch konzentriert und die Zahlen nach Sprache aufschlüsselt. Kumulativ erstellte und behobene Probleme: Ein Liniendiagramm, das die kumulative Anzahl erstellter und behobener Probleme visualisiert.
Durchschnittliche Lösungszeit nach Problemtyp: Ein Balkendiagramm mit der durchschnittlichen Anzahl von Tagen, die zum Beheben jedes Problemtyps benötigt werden.
- Top-Melder und -Löser: Eine Bestenliste der Mitglieder, die die meisten Probleme gemeldet und behoben haben, mit sortierbaren Spalten für Name, Gemeldete Probleme und Behobene Probleme.
- Projektmitglieder
- Dieser Bericht hilft dir, die Aktivitäten und Änderungen unter deinen Projektmitgliedern zu überwachen. So können Manager den Grad der Beteiligung beurteilen.
- Der Bericht zeigt für den ausgewählten Zeitraum wichtige Kennzahlen zu deinen Mitgliedern, einschließlich:
- Gesamt (Ende des Zeitraums): Die Gesamtzahl der Mitglieder im Projekt.
Aktiv: Die Anzahl der Mitglieder, die während des Zeitraums aktiv waren.
Abschnitt betitelt „Aktiv: Die Anzahl der Mitglieder, die während des Zeitraums aktiv waren.“Ein aktives Mitglied ist ein Mitwirkender, der übersetzungsbezogene Aktivitäten ausführt, z. B. Vorschläge hinzufügen, Übersetzungen genehmigen, abstimmen, Zeichenfolgen kommentieren oder Glossarbegriffe verwalten. Du kannst die Daten nach Datumsbereich filtern. Neu: Die Anzahl der neu hinzugekommenen Mitglieder.
- Ausstehend (Ende des Zeitraums): Die Anzahl der Benutzer mit ausstehenden Beitrittsanfragen (einschließlich eingehender und ausgehender Einladungen).
- Blockiert (Ende des Zeitraums): Die Anzahl der blockierten Mitglieder.
- Verwende diesen Bericht, um dein Budget zu planen und die ungefähren Übersetzungskosten zu berechnen.
- Lege die Übersetzungs- und Genehmigungstarife fest, um die Kosten für nicht übersetzte und nicht genehmigte Zeichenfolgen im Projekt anzuzeigen.
- Du kannst einen Bericht zur Kostenschätzung anhand der folgenden Filterparameter erstellen:
Aufgabe: Nicht ausgewählt, alle Aufgaben oder mehrere bestimmte Aufgaben.
Verwende diesen Bericht, um dein Budget zu planen und die ungefähren Übersetzungskosten zu berechnen. Lege die Übersetzungs- und Genehmigungstarife fest, um die Kosten für nicht übersetzte und nicht genehmigte Strings im Projekt anzuzeigen.
Du kannst einen Bericht zur Kostenschätzung anhand der folgenden Filterparameter erstellen:
- Aufgabe: Nicht ausgewählt, alle Aufgaben oder mehrere bestimmte Aufgaben.
- Hinzugefügte Strings: Heute, Letzte 7 Tage, Letzte 30 Tage, Dieser Monat, Gesamter Zeitraum oder benutzerdefinierter Zeitraum.
- Dateien: Alle oder bestimmte Dateien.
- Labels (spezifisch für Projekte mit Labels): Nicht ausgewählt, Strings mit ausgewählten Labels oder Strings ohne ausgewählte Labels.
- Sprache: Alle Sprachen oder eine bestimmte Zielsprache.
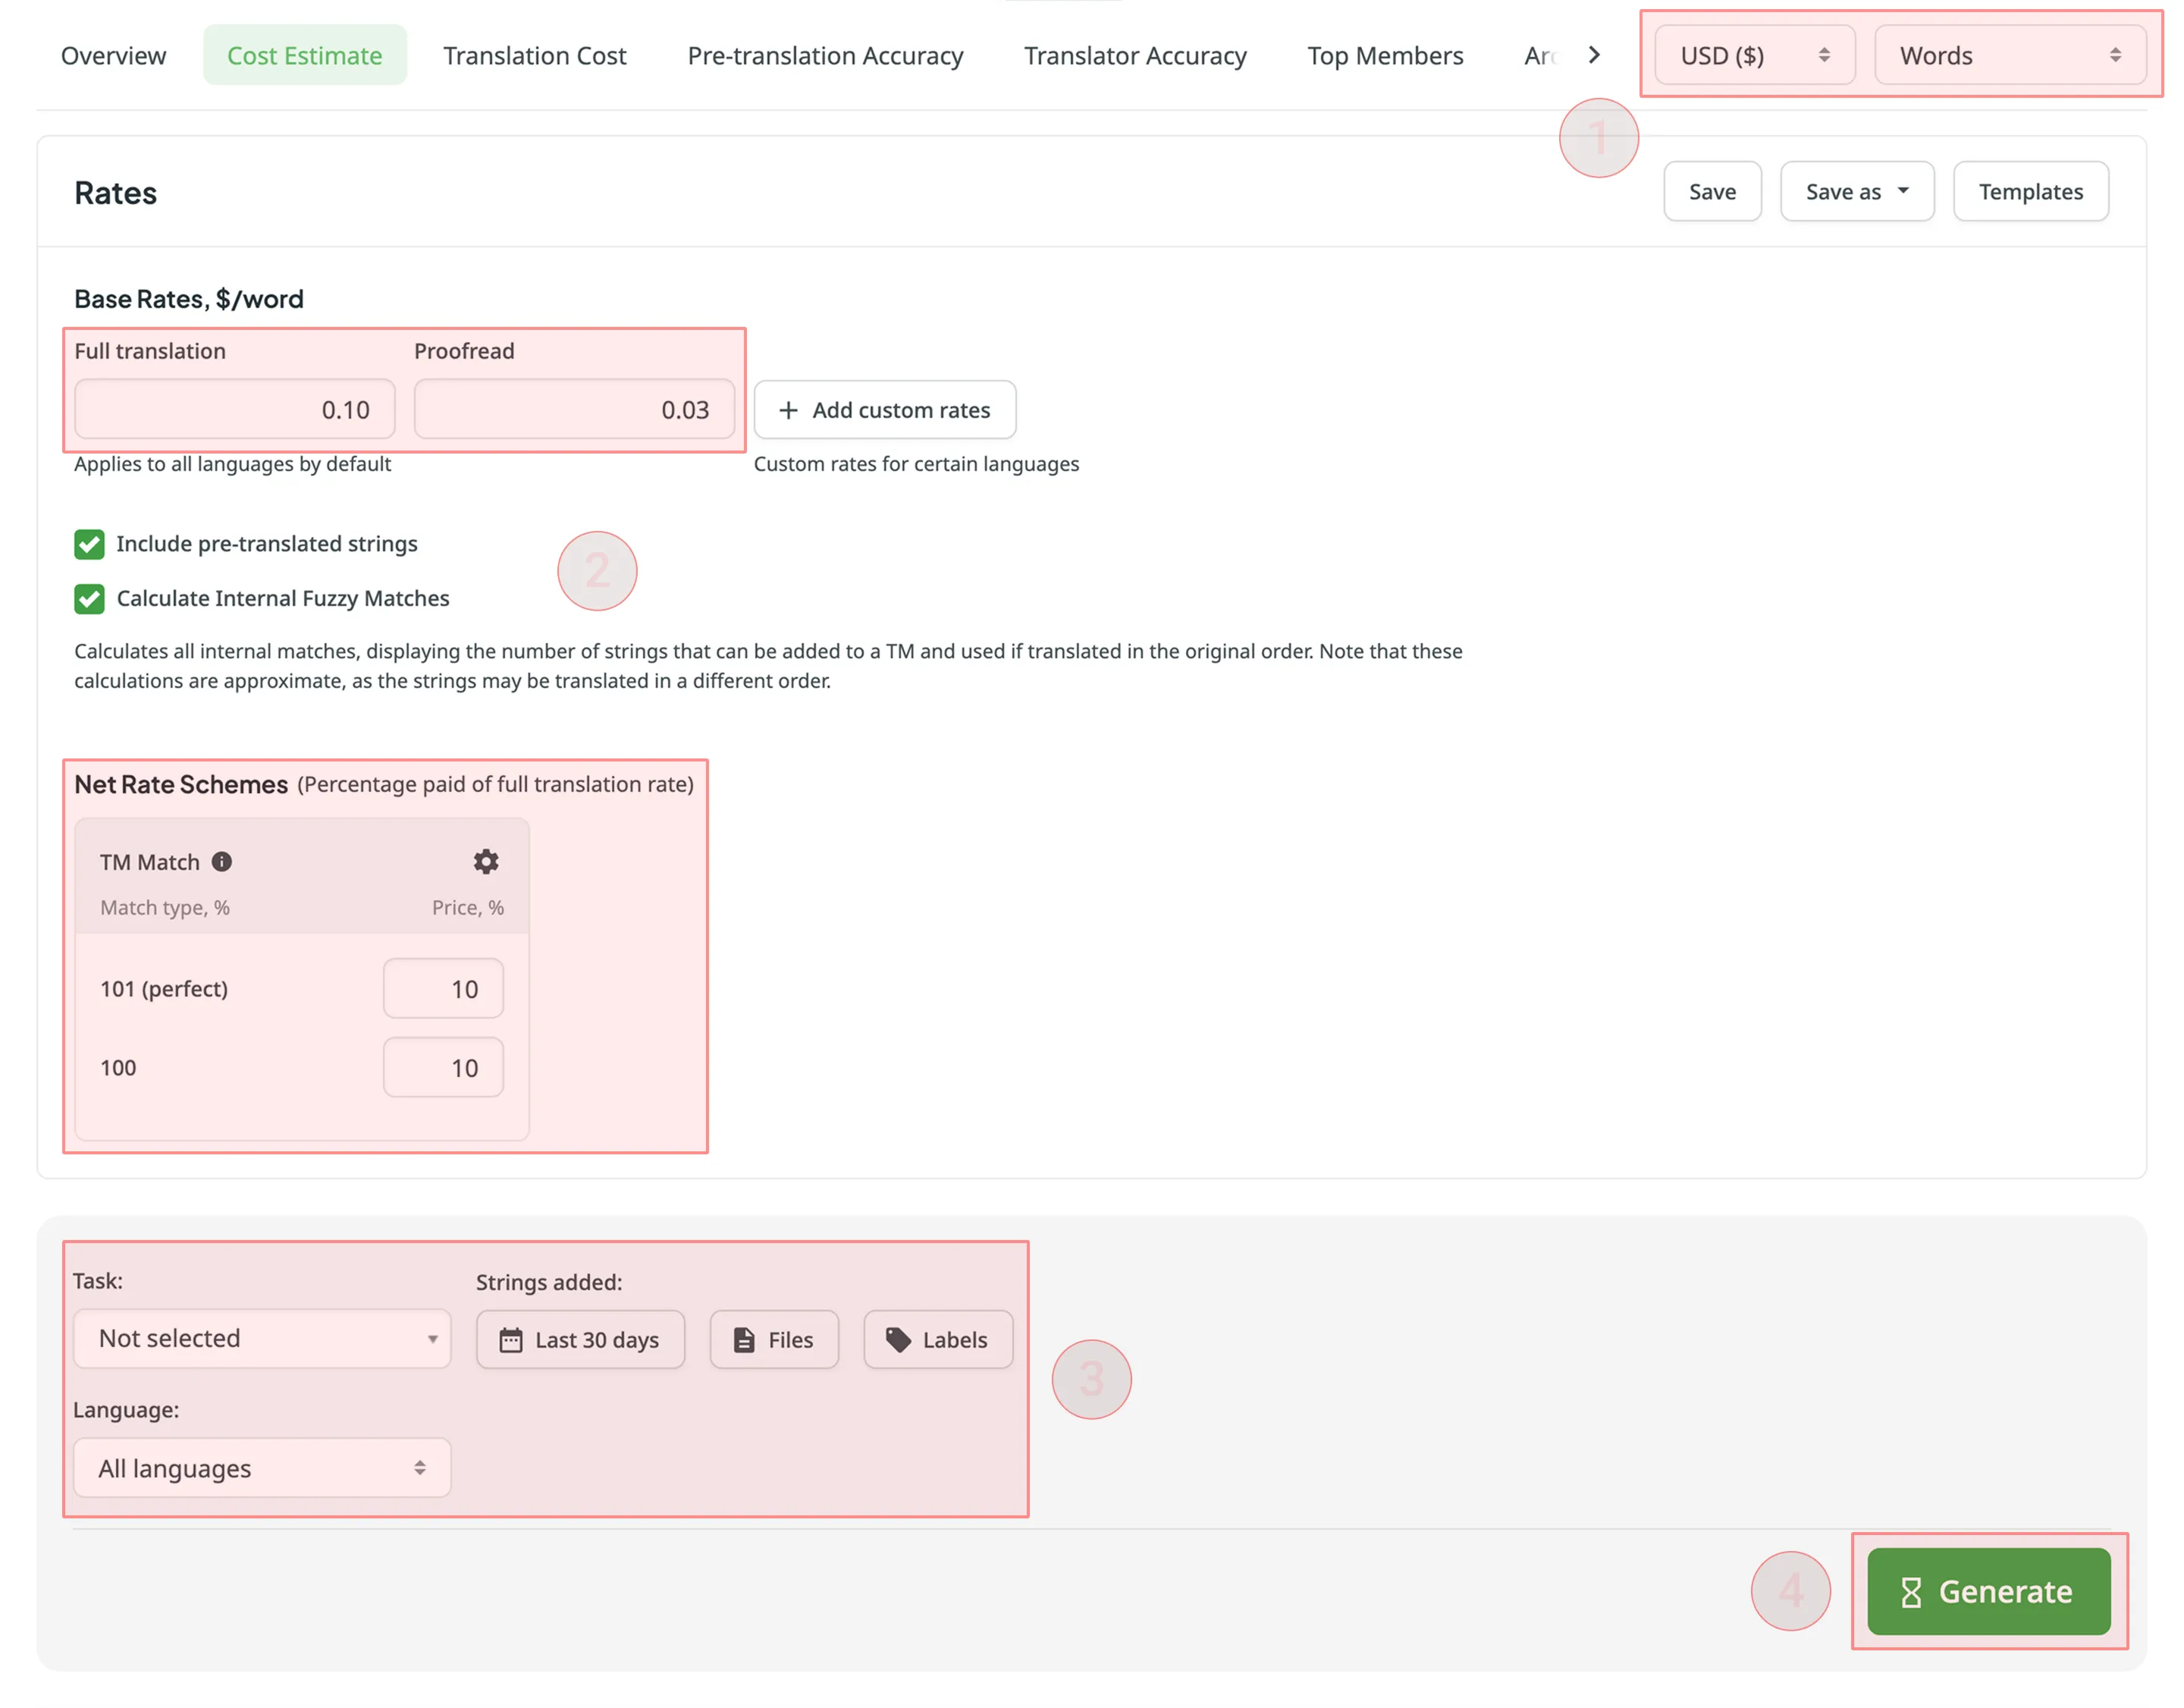
Um den Bericht zur Kostenschätzung zu erstellen, gehe wie folgt vor:
- Wähle die gewünschte Währung und Berichtseinheit aus (Wörter, Strings, Zeichen ohne Leerzeichen oder Zeichen mit Leerzeichen).
- Lege deine Tarife für Übersetzungen und Genehmigungen fest.
- Verwende die verfügbaren Filterparameter, um die Berichtsdaten festzulegen, die dich interessieren.
- Klicke auf Generieren.
Nachdem du auf Generieren geklickt hast, wird der Bericht zur Kostenschätzung einer Warteschlange hinzugefügt und im Hintergrund verarbeitet. So wird sichergestellt, dass mehrere von unterschiedlichen Benutzern oder mit unterschiedlichen Filtern erstellte Berichte nicht gegenseitig überschrieben werden. Jeder Bericht wird separat erstellt und nach Abschluss im Bereich Berichte > Archiv angezeigt.
Wenn ein Bericht zur Warteschlange hinzugefügt wird, erscheint eine Benachrichtigung, die die Einreihung des Berichts in die Warteschlange bestätigt und schnellen Zugriff auf die Warteschlange oder zum Schließen der Meldung bietet.
Während der Bericht erstellt wird, zeigt ein Pop-up unten rechts auf dem Bildschirm den Status der Warteschlange an. Der Status wird automatisch aktualisiert, während der Bericht erstellt wird:
- Ausstehend – der Bericht wartet in der Warteschlange und wurde noch nicht verarbeitet.
- In Bearbeitung – die Erstellung des Berichts wurde gestartet. Ein Fortschrittsbalken zeigt den aktuellen Prozentsatz an.
- Abgeschlossen – der Bericht wurde erfolgreich erstellt und kann über das Archiv aufgerufen werden.
- Fehlgeschlagen – bei der Erstellung des Berichts ist ein Fehler aufgetreten.
Jeder Bericht wird unabhängig verarbeitet, sodass du sicher mehrere Berichte zur Kostenschätzung mit unterschiedlichen Filtern erstellen kannst, ohne bereits gestartete und noch laufende Berichte zu beeinflussen.
Du kannst die Preise für Basistarife (vollständige Übersetzung, Korrekturlesen) festlegen und Nettotarifschemata konfigurieren (Prozentsatz des Tarifs für die vollständige Übersetzung, der für Übersetzungen mit TM-Vorschlägen gezahlt wird).
Im Abschnitt „Basistarife“ kannst du Tarife für die folgenden Arbeitsarten festlegen:
- Vollständige Übersetzung – für jede von einer Person erstellte Übersetzung.
- Korrekturlesen – für jede genehmigte Übersetzung.
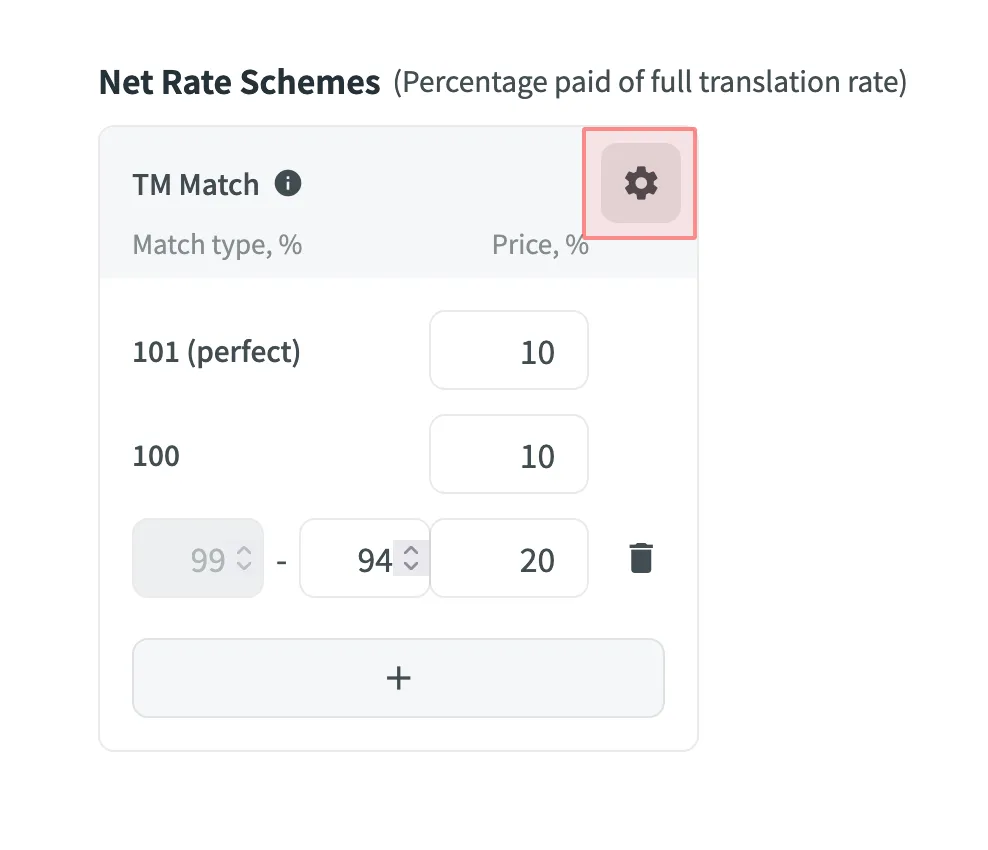
Im Abschnitt „Nettotarifschemata“ kannst du zusätzlich zu den Basistarifen den Prozentsatz des Tarifs für die vollständige Übersetzung festlegen, der für Übersetzungen mit TM-Vorschlägen verschiedener TM-Treffertypen gezahlt wird. Standardmäßig kannst du den Prozentsatz des Tarifs für die vollständige Übersetzung für die folgenden TM-Treffertypen konfigurieren:
- 101 (perfekt) – für Übersetzungen, die mit TM-Vorschlägen mit perfektem Treffer erstellt wurden (Ausgangsstrings sind sowohl nach Text als auch nach Kontext mit dem TM-Vorschlag identisch).
- 100 – für Übersetzungen, die mit TM-Vorschlägen mit 100-%-Treffer erstellt wurden (Ausgangsstrings sind nur nach Text mit dem TM-Vorschlag identisch).
Du kannst auch eigene TM-Treffertypen hinzufügen und dabei den gewünschten Prozentsatz der Textähnlichkeit sowie den Prozentsatz des Tarifs für die vollständige Übersetzung festlegen, der für eine solche Übersetzung gezahlt wird.
Um eigene TM-Treffertypen hinzuzufügen, gehe wie folgt vor:
- Klicke im Abschnitt „Nettotarifschemata“ auf .
- Klicke auf die daraufhin angezeigte Schaltfläche .
- Lege den TM-Trefferbereich und den Prozentsatz des Tarifs für die vollständige Übersetzung fest.
- Klicke auf , um die Einstellungen zu speichern.
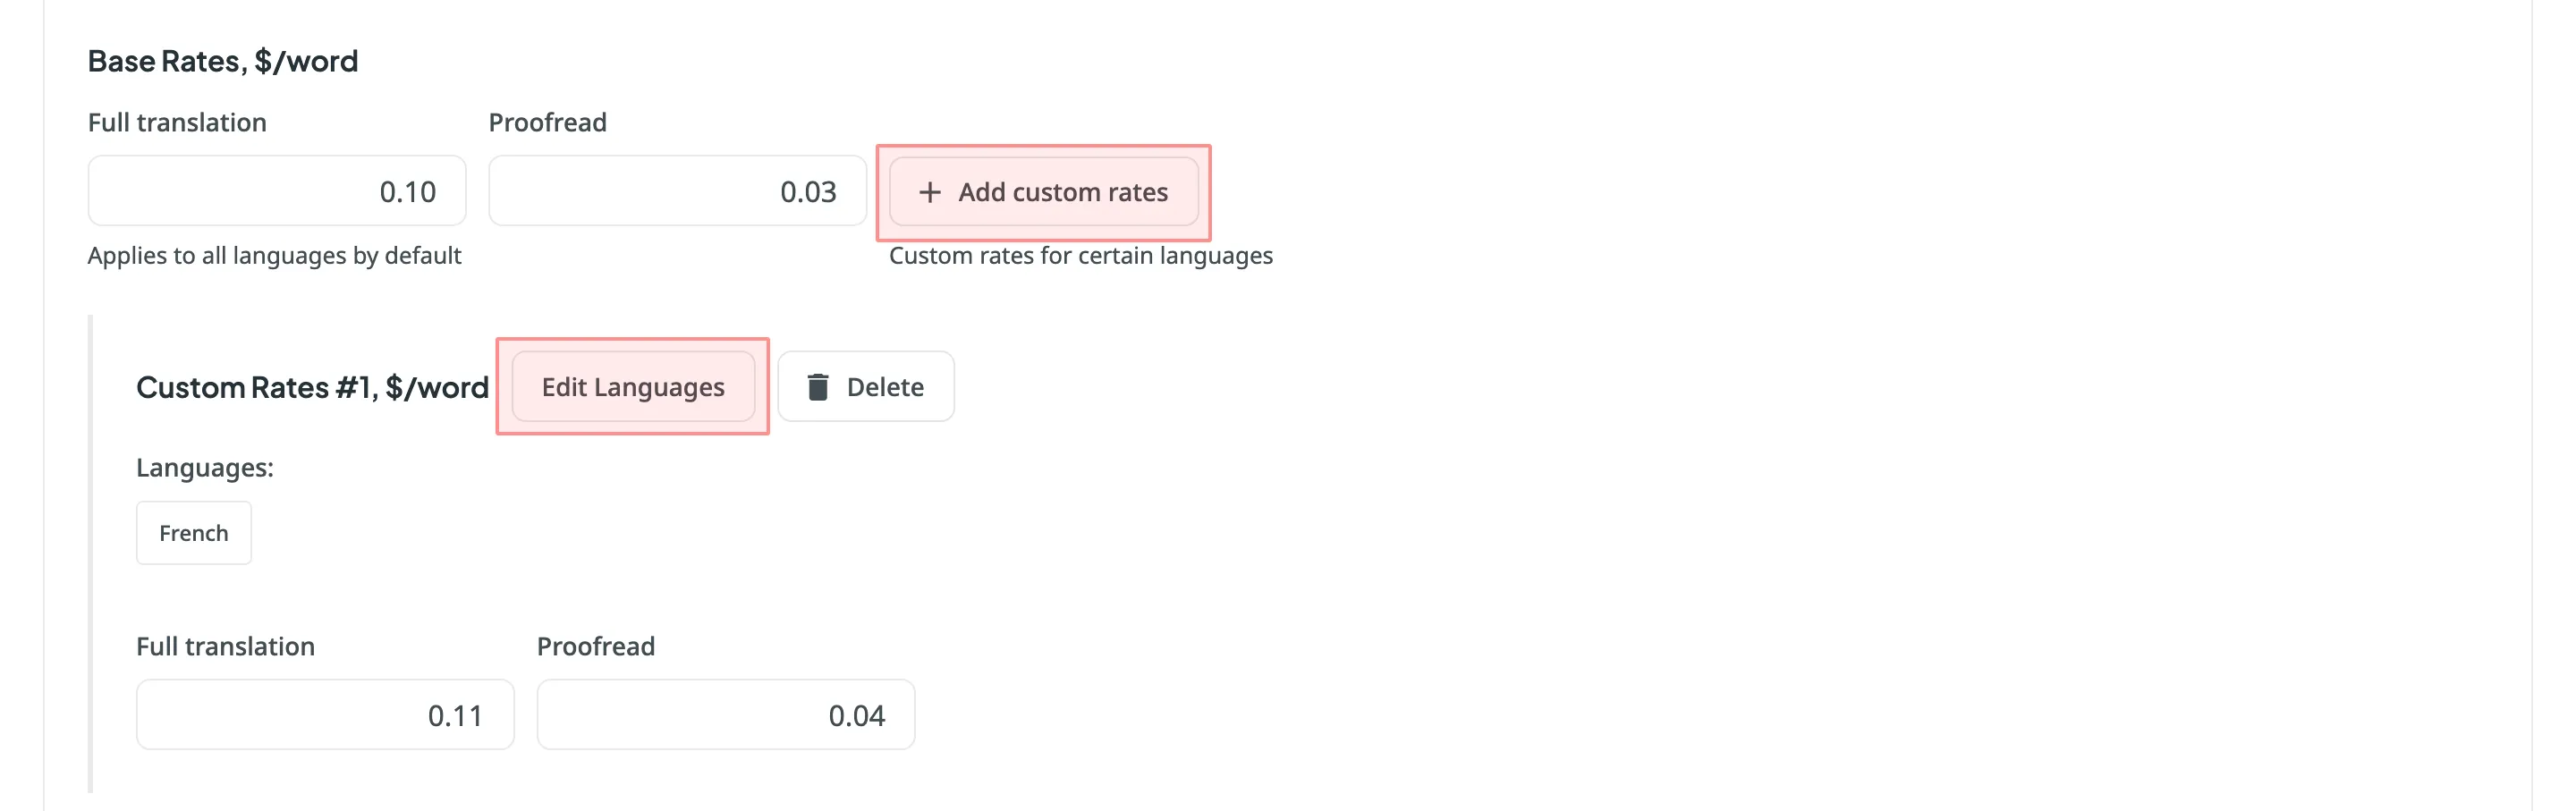
Zusätzlich zu den standardmäßig auf alle Sprachen angewendeten Basistarifen kannst du benutzerdefinierte Tarife für bestimmte Sprachen hinzufügen. Um benutzerdefinierte Tarife hinzuzufügen, klicke auf Benutzerdefinierte Tarife hinzufügen.
Um die Sprache bzw. Sprachen für benutzerdefinierte Tarife auszuwählen, klicke auf Sprachen bearbeiten und wähle die gewünschten Sprachen aus. Du kannst beliebig viele benutzerdefinierte Tarife erstellen.
Wenn du mit mehreren Tarifkonfigurationen arbeiten möchtest, speichere sie als Vorlagen, indem du auf Speichern unter > Neue Tarifvorlage klickst. Gib anschließend den Vorlagennamen ein und klicke auf Speichern.
Beim Speichern einer neuen Vorlage kannst du anhand der folgenden Optionen deren Sichtbarkeit auswählen:
-
Für alle Projektmitglieder freigeben – macht die Vorlage für alle Übersetzer innerhalb des Projekts sichtbar. Unabhängig von der Anzahl der Übersetzer oder ihren unterschiedlichen Tarifen haben alle Zugriff auf die Vorlage. Sie kann sowohl allgemeine Tarife als auch benutzerdefinierte Tarife für bestimmte Sprachen und Übersetzer sowie ein Nettotarifschema enthalten. Diese Transparenz sorgt für Klarheit bei der Preisgestaltung und ermöglicht Übersetzern, Tarife zu prüfen, Berichte über ihre Übersetzungen zu erstellen und Kostenschätzungen zu berechnen. Der wichtigste Vorteil besteht darin, dass Übersetzer das Nettotarifschema verstehen und ihren Basistarif anwenden können, auch wenn dieser nicht in der Vorlage enthalten ist.
-
Für Manager in den Projekten des Eigentümers freigeben – macht die Vorlage global sichtbar, jedoch nur für Manager in allen Projekten eines Eigentümers. Diese Option sorgt für eine einheitliche Tarifgestaltung über verschiedene Projekte hinweg.
Wenn keine der Optionen ausgewählt ist, bleibt die Vorlage nur für Manager im aktuellen Projekt sichtbar, sodass der Zugriff auf eine ausgewählte Gruppe von Projektmitgliedern beschränkt ist. Diese Optionen bieten Flexibilität bei der Steuerung, wer die Tarifvorlage anzeigen und verwenden kann, um unterschiedlichen organisatorischen Anforderungen gerecht zu werden.
Gespeicherte Vorlagen ermöglichen dir, schnell zwischen verschiedenen Konfigurationen für die Berichtserstellung zu wechseln.
Klicke auf Vorlagen, um deine gespeicherten Tarifvorlagen anzuzeigen und zu verwalten.
Automatisch übersetzte Strings einschließen
Abschnitt betitelt „Automatisch übersetzte Strings einschließen“Wähle Automatisch übersetzte Strings einschließen, wenn du automatisch übersetzte Strings in einen Bericht zur Kostenschätzung aufnehmen möchtest. Standardmäßig ist diese Option ausgewählt.
Angenommen, dein Projekt enthält einen nicht übersetzten String Validate your username. Du erstellst einen Bericht zur Kostenschätzung mit ausgewählter Option Automatisch übersetzte Strings einschließen. Dieser String wird in die Kostenschätzung aufgenommen. Anschließend übersetzt du diesen String über eine TM- oder MT-Engine automatisch und erstellst erneut einen Bericht zur Kostenschätzung mit ausgewählter Option Automatisch übersetzte Strings einschließen. Diesmal wird der automatisch übersetzte String Validate your username nicht in den Bericht zur Kostenschätzung aufgenommen.
Wenn dagegen die Option Automatisch übersetzte Strings einschließen deaktiviert ist, wird der String Validate your username beide Male in den Bericht zur Kostenschätzung aufgenommen – sowohl wenn er nicht übersetzt als auch wenn er über eine TM- oder MT-Engine automatisch übersetzt wurde.
Interne Fuzzy-Treffer sind partielle (unscharfe) TM-Treffer unter den nicht übersetzten Strings in deinem Projekt, die potenziell zum Translation Memory hinzugefügt werden können. Wenn beispielsweise der erste String in einer Datei Validate your username und der letzte Validate your username again lautet, liegt ein interner Fuzzy-Treffer vor.
Um Fuzzy-Treffer (99 % und weniger) sowie perfekte (101 %) und 100-%-Treffer in deinen Bericht zur Kostenschätzung aufzunehmen und eine umfassendere Prognose darüber zu erhalten, wie viele Strings zum TM hinzugefügt werden können, wenn sie nacheinander übersetzt werden, wähle Interne Fuzzy-Treffer berechnen aus. Beachte, dass diese Berechnungen Näherungswerte sind, da die tatsächliche Übersetzungsreihenfolge abweichen kann.
Wenn du Interne Fuzzy-Treffer berechnen deaktivierst, zeigt der Bericht zur Kostenschätzung nur perfekte (101 %) und 100-%-interne Treffer (Wiederholungen) an und enthält keine Fuzzy-Treffer.
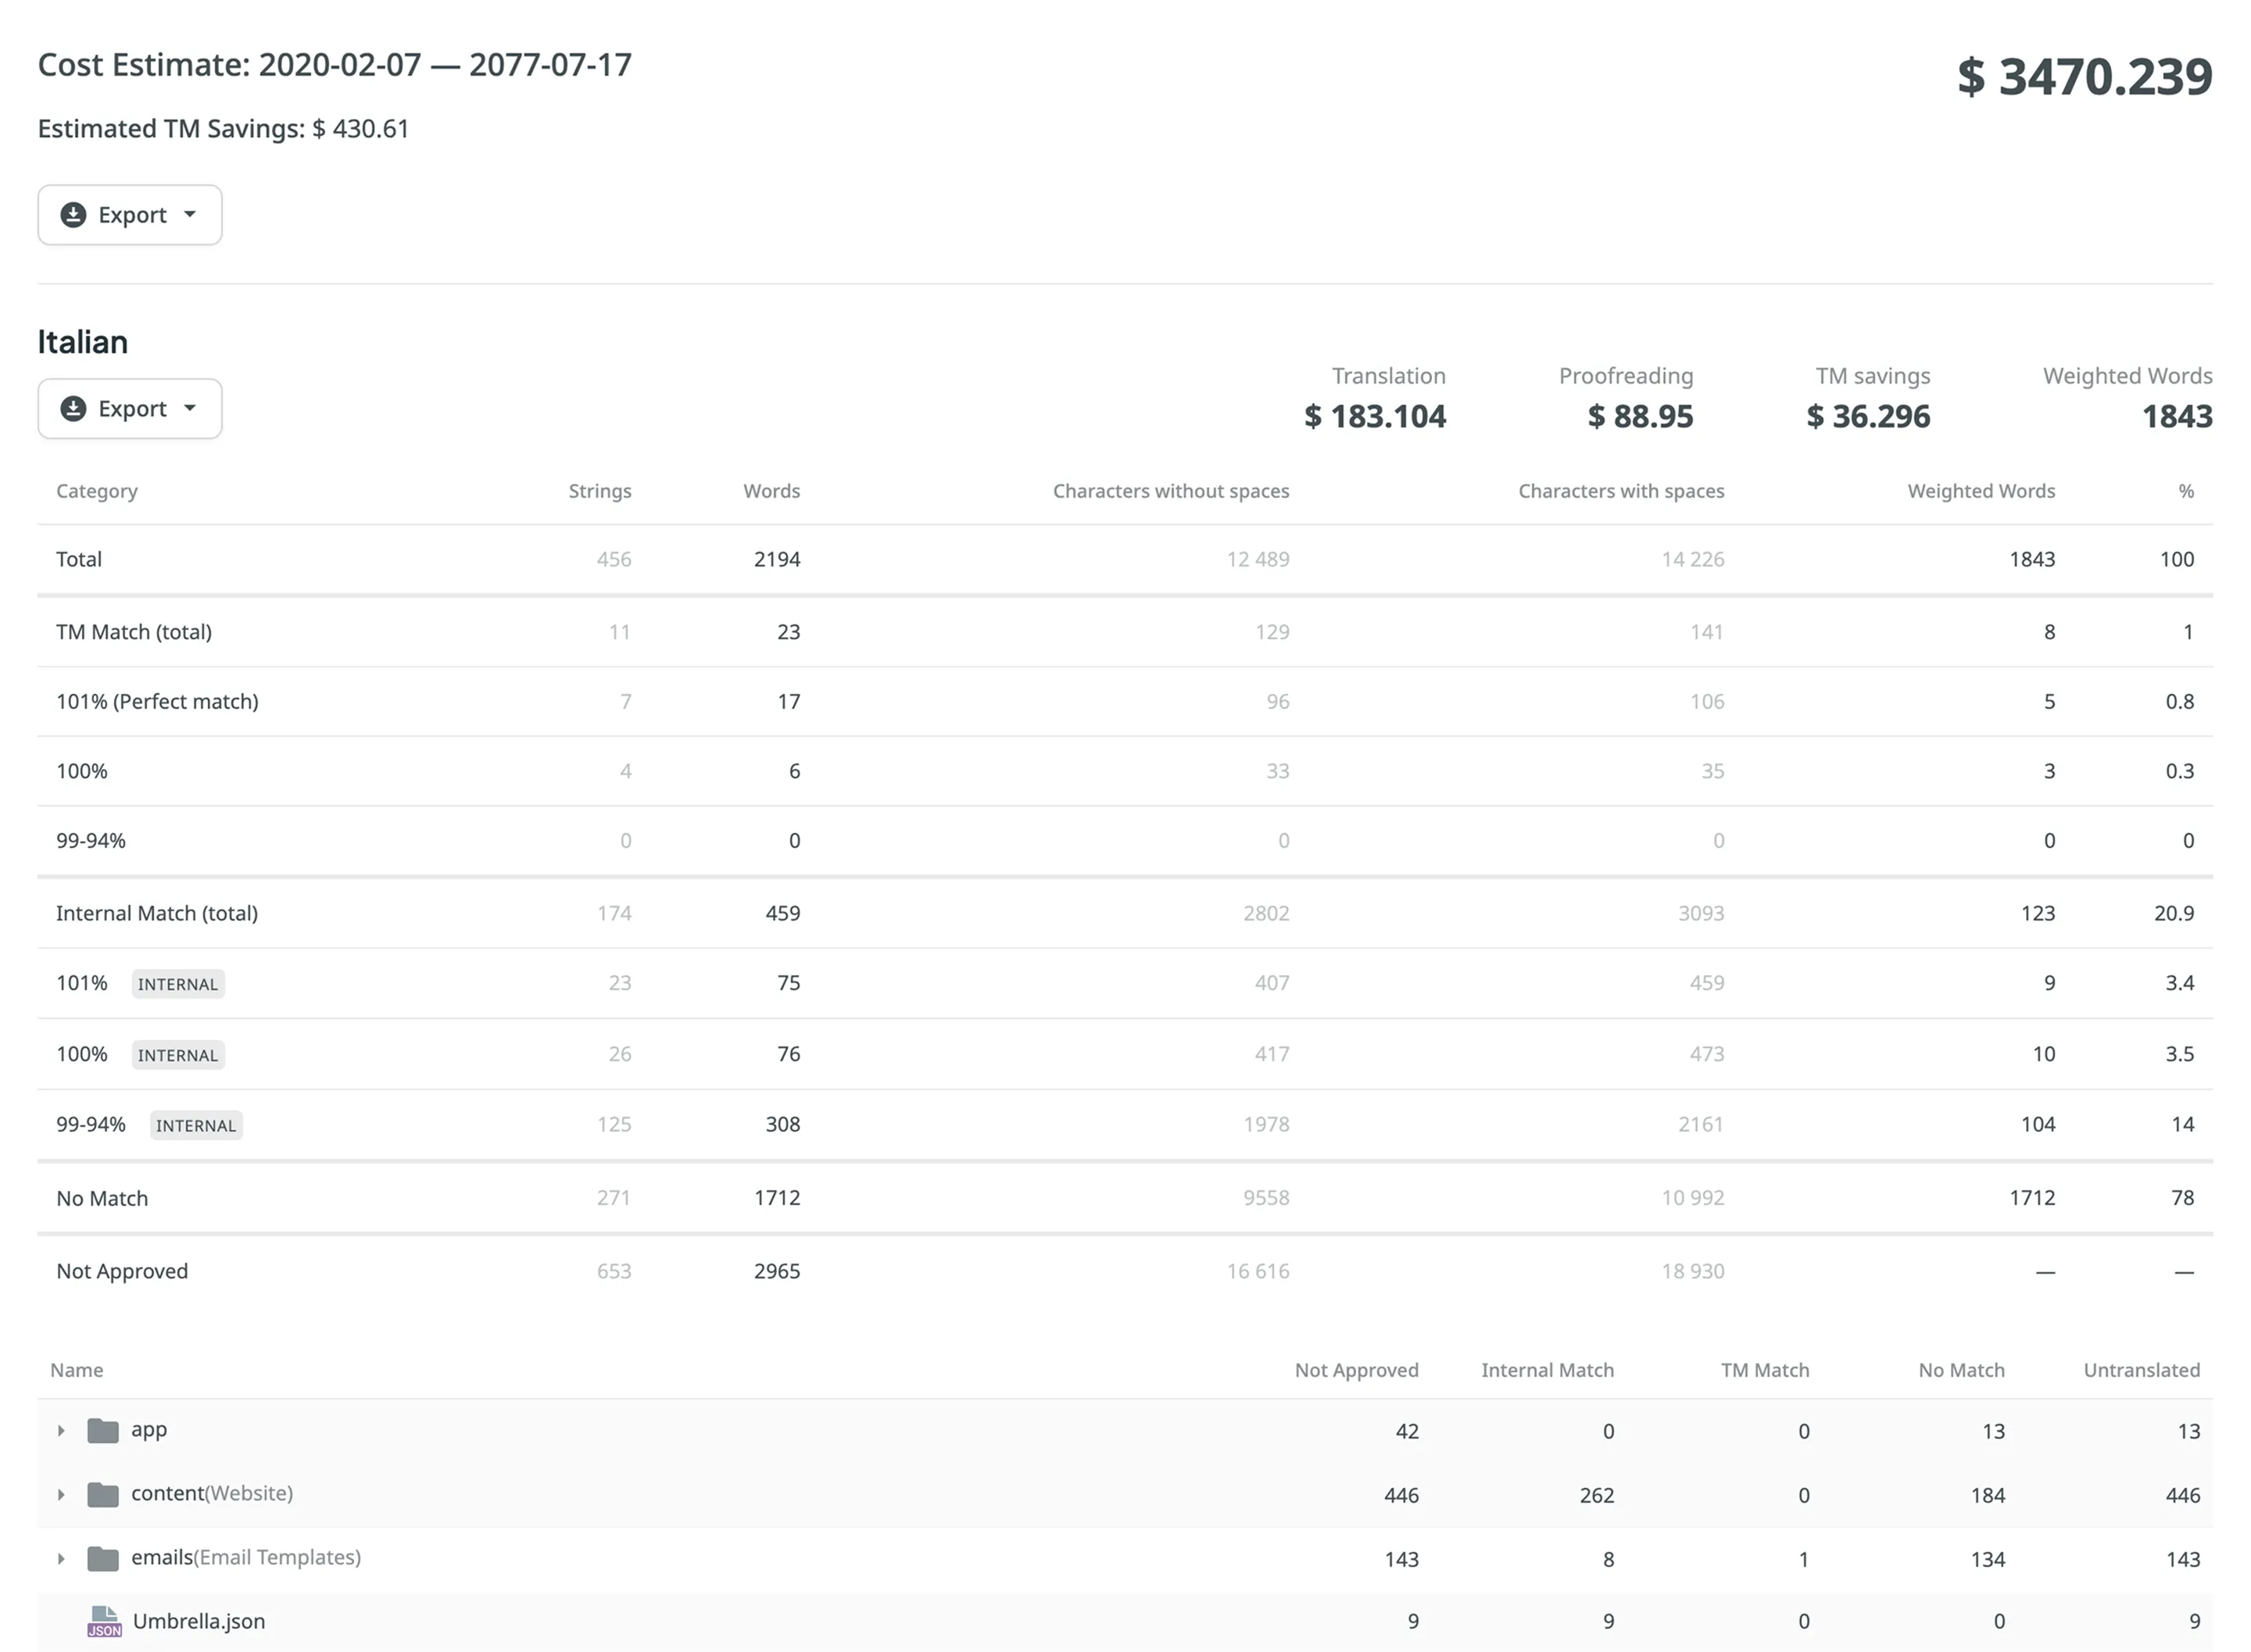
Bei der Erstellung des Berichts zur Kostenschätzung werden die folgenden Details angezeigt:
- Gesamt – Allgemeine Kostenschätzung für alle Sprachen (einschließlich Übersetzung, Korrekturlesen und aller TM-Einsparungen).
- Zwischensummen – Kostenschätzung für jede Zielsprache:
- Übersetzung – Kosten für Strings, die neue oder aktualisierte Übersetzungen erfordern (ohne Nutzung von Treffern mit hohem Prozentsatz).
- Korrekturlesen – Kosten für die Überprüfung von Übersetzungen.
- TM-Einsparungen – Einsparungen durch vorhandene Übersetzungen (im TM oder innerhalb des Projekts).
- Gewichtete Wörter / Strings / Zeichen / Zeichen mit Leerzeichen – Endgültige Wortanzahl für Kostenberechnungen nach Anwendung von TM-/internen Treffer-Rabatten.
Jede Zeile in der Haupttabelle stellt eine Trefferkategorie oder einen Status dar:
-
Gesamt – Fasst alle Strings, Wörter und Zeichen sowie die gewichteten Einheiten nach Abzug von Trefferrabatten und als Prozentsatz des Gesamtwerts zusammen.
-
TM-Treffer (gesamt) – Nicht übersetzte Strings, die mit Einträgen im Translation Memory übereinstimmen, häufig aufgeteilt in:
- 101 % (perfekt) – Exakte Übereinstimmung von Text und Kontext.
- 100 % – Exakte Textübereinstimmung, aber abweichender Kontext.
-
Wiederholungen (gesamt) oder interner Treffer (gesamt) – Nicht übersetzte Strings, die mit anderen Strings innerhalb des Projekts übereinstimmen. Die Anzeige hängt davon ab, ob Interne Fuzzy-Treffer berechnen aktiviert ist. Unterkategorien (z. B. 101 %, 100 % und Fuzzy) hängen von deinen Nettotarifschemata ab.
Wenn ein nicht übersetzter String sowohl einen 101-%-TM-Treffer als auch einen 100-%-internen Treffer aufweist, wird er als TM-Treffer gezählt.
-
Kein Treffer – Strings ohne TM- oder interne Treffer, die von Grund auf übersetzt werden müssen.
-
Nicht genehmigt – übersetzte Strings, die noch auf Genehmigung warten.
-
Nicht übersetzt – vollständig nicht übersetzte Strings, die eine vollständige Übersetzung erfordern.
- Strings / Wörter / Zeichen / Zeichen mit Leerzeichen – Grundlegende Umfangskennzahlen.
- Gewichtete Wörter / Strings / Zeichen / Zeichen mit Leerzeichen – Zeigt die angepasste Kennzahl nach Berücksichtigung von Wiederholungen und Fuzzy-Treffern an und spiegelt den tatsächlichen Übersetzungsaufwand wider.
- % – Anteil der gewichteten Einheiten in jeder Kategorie.
Nach der Haupttabelle enthält jede Sprachzwischensumme außerdem eine Tabelle mit Daten für jeden Ordner bzw. jede Datei. Sie zeigt, wie viele Strings Nicht genehmigt, Nicht übersetzt, TM-Treffer, interne Treffer oder Kein Treffer sind. Dies hilft dir dabei zu erkennen, worauf du deine Übersetzungsarbeit und dein Budget konzentrieren solltest.
Um den Bericht zur Kostenschätzung herunterzuladen, klicke auf Exportieren und wähle das gewünschte Format (CSV, XLSX oder JSON) zur weiteren Analyse oder Dokumentation aus.
Verwende diesen Bericht, um die tatsächlichen Übersetzungs- und Korrekturlesekosten anhand des von Mitwirkenden abgeschlossenen Umfangs (z. B. Wörter) zu berechnen.
Du kannst einen Bericht zu den Übersetzungskosten anhand der folgenden Filterparameter erstellen:
- Aufgabe: Nicht ausgewählt, alle Aufgaben oder mehrere bestimmte Aufgaben.
- Datumsbereich: Heute, Gestern, Letzte 7 Tage, Letzte 30 Tage, Dieser Monat, Letzter Monat, Gesamter Zeitraum oder benutzerdefinierter Zeitraum.
- Dateien: Alle Dateien (einschließlich gelöschter Dateien und Strings) oder ausgewählte Dateien (einschließlich gelöschter Strings).
- Branches (spezifisch für stringbasierte Projekte): Alle Branches oder ausgewählte Branches.
- Labels (spezifisch für Projekte mit Labels): Nicht ausgewählt, Strings mit ausgewählten Labels oder Strings ohne ausgewählte Labels.
- Sprache: Alle oder eine bestimmte Zielsprache.
- Mitglied: Alle oder bestimmte Benutzer.
- Gruppieren nach: Mitglied oder Sprache.
Um den Bericht zu den Übersetzungskosten zu erstellen, gehe wie folgt vor:
- Wähle die gewünschte Währung und Berichtseinheit aus (Wörter, Strings, Zeichen ohne Leerzeichen oder Zeichen mit Leerzeichen).
- Lege deine Tarife fest.
- (Optional) Konfigurieren Sie die Erweiterten Einstellungen.
- Verwende die verfügbaren Filterparameter, um die Berichtsdaten festzulegen, die dich interessieren.
- (Optional) Deaktiviere Im Archiv speichern, wenn du den Bericht nicht im Archiv speichern möchtest.
- Klicke auf Generieren.
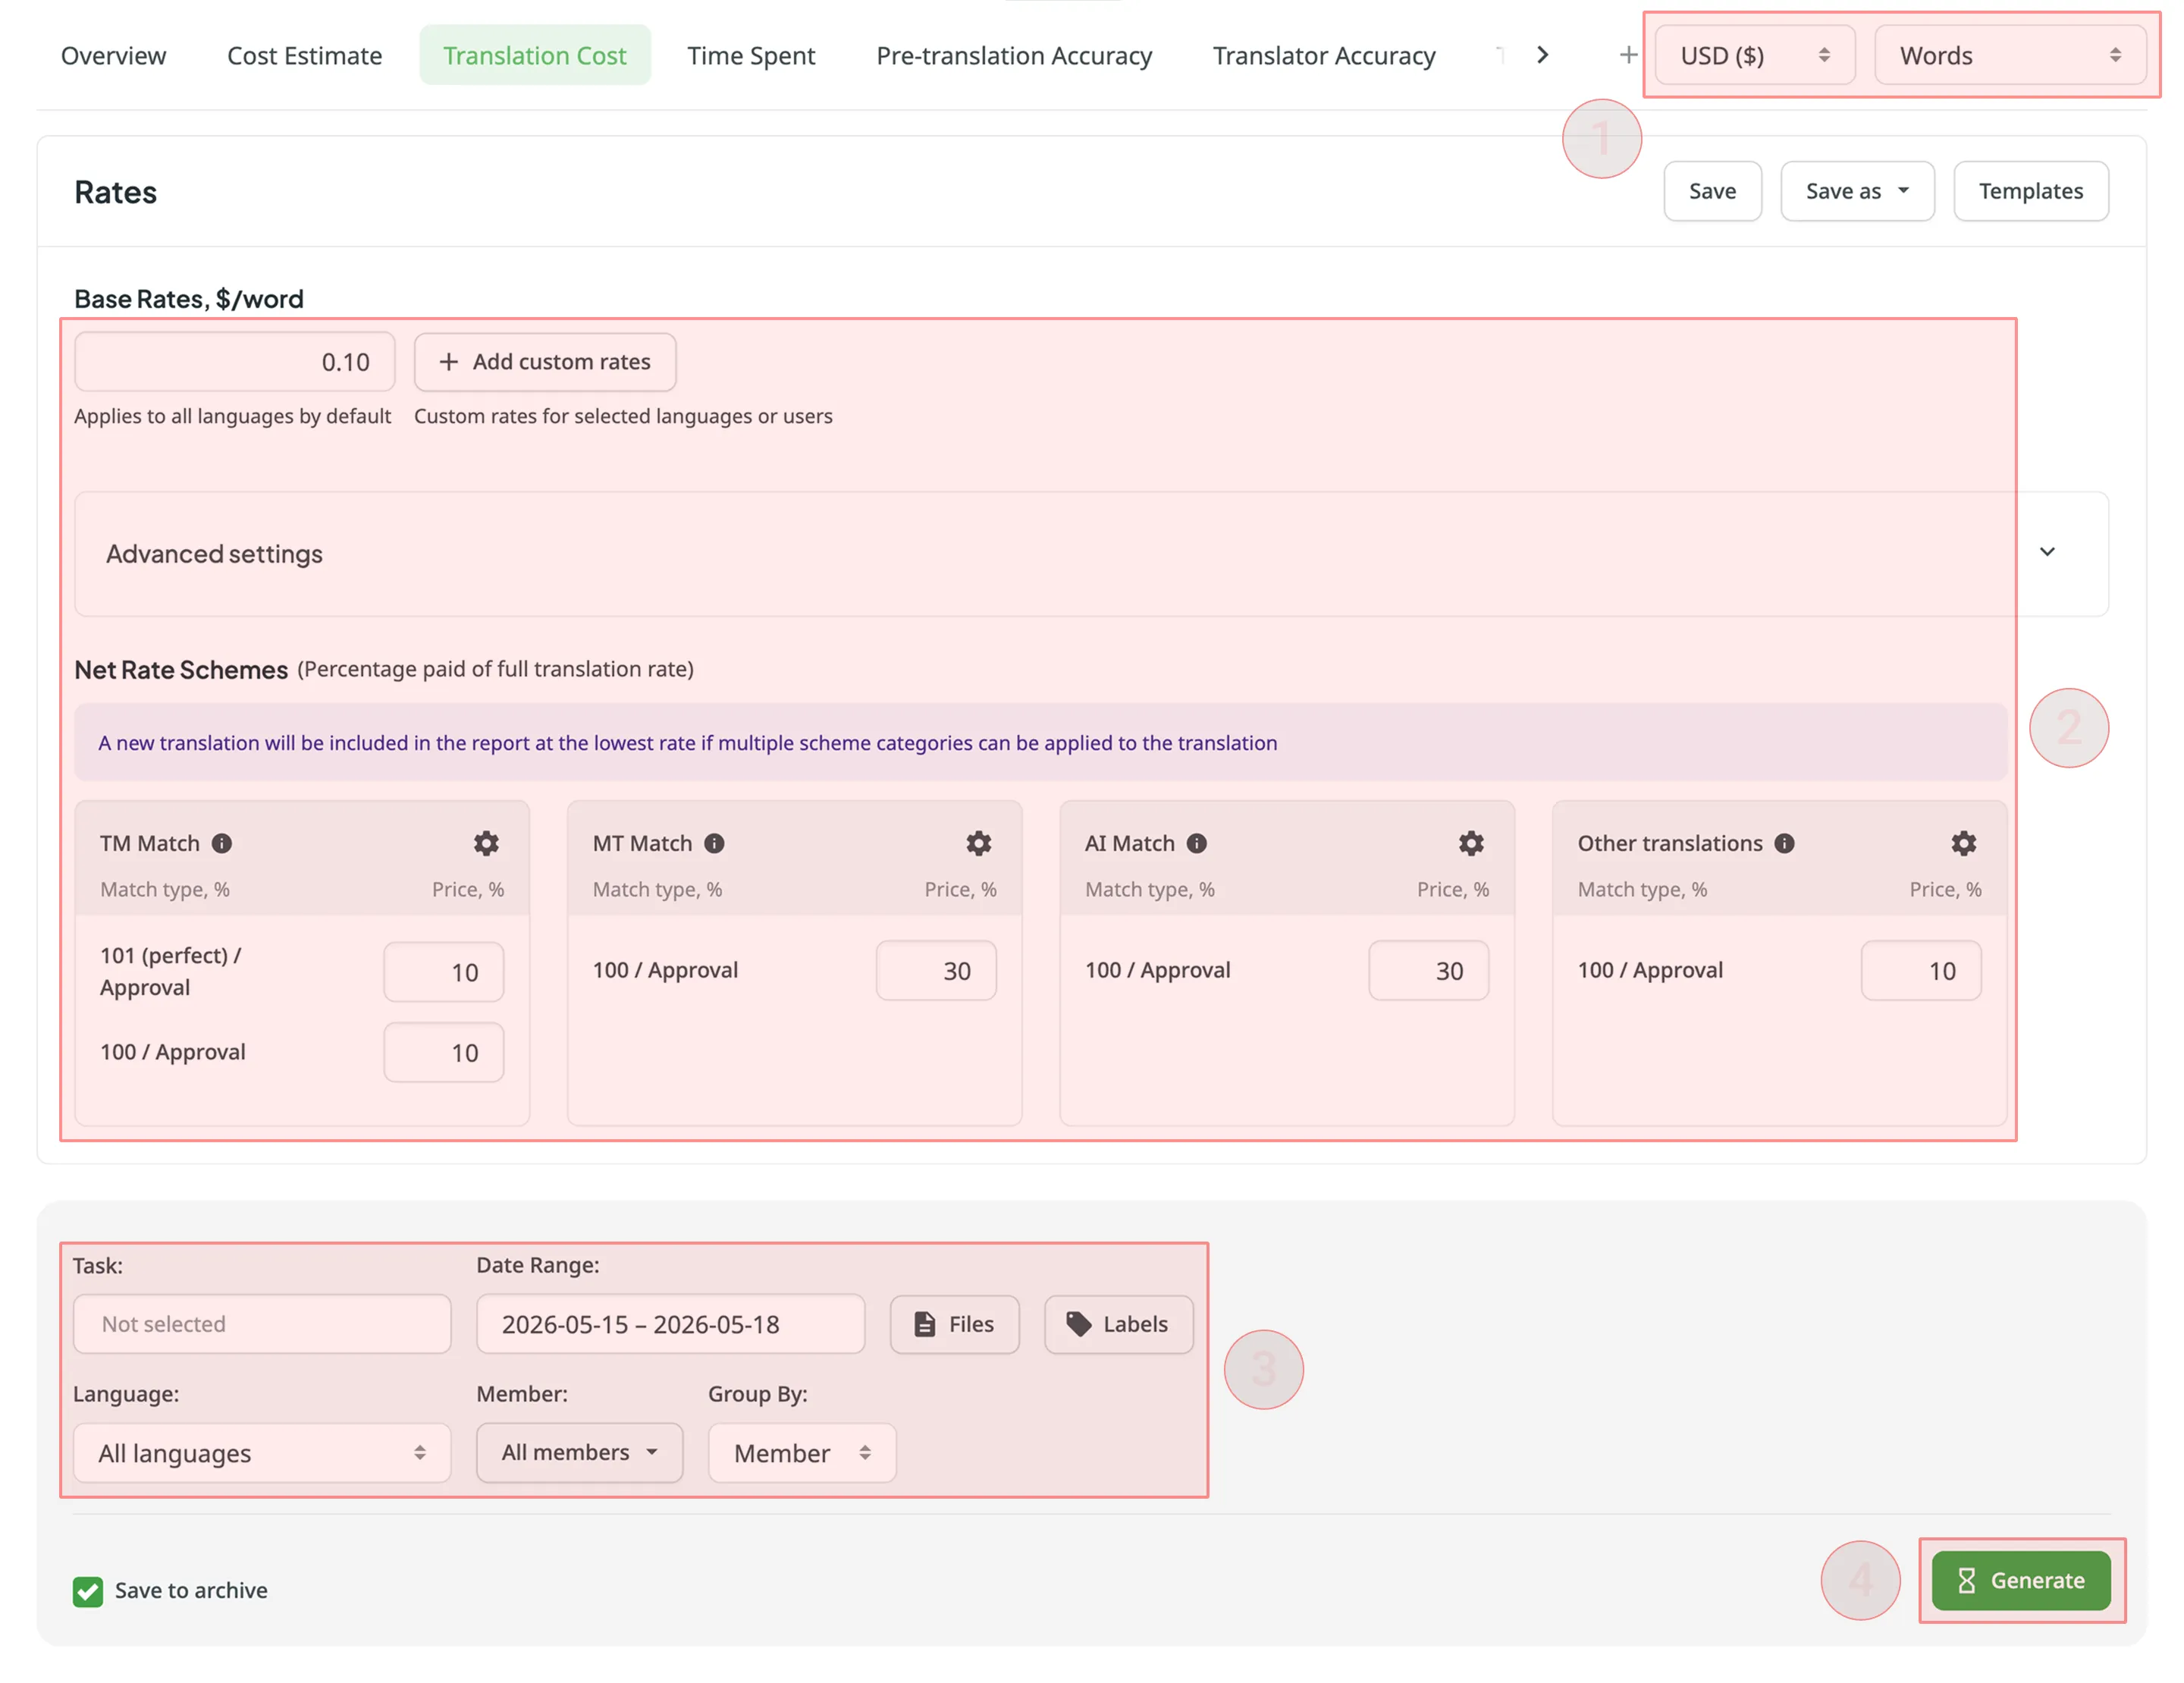
Du kannst die Preise für Basistarife festlegen und Nettotarifschemata konfigurieren (Prozentsatz des Tarifs für die vollständige Übersetzung, der für Übersetzung und Korrekturlesen auf Grundlage von TM-Treffer, MT-Treffer, KI-Treffer und anderen Übersetzungen gezahlt wird).
Im Bereich Basistarife kannst du den Tarif für die folgenden Arbeitsarten festlegen:
- Vollständige Übersetzung – für jede von einer Person erstellte Übersetzung.
Klicke auf Erweiterte Einstellungen, um einen Bereich mit zusätzlichen Konfigurationsoptionen für deinen Bericht zu erweitern:
- Korrekturlesetarife nach Kategorie verwenden (standardmäßig aktiviert): Behandelt jede Genehmigung als identische Übersetzung mit einem 100-%-Trefferwert der Kategorie ihres Nettotarifschemas (TM, MT, KI oder Andere). Wenn deaktiviert, verwenden alle Genehmigungen den pauschalen Basistarif Korrekturlesen.
- Freigaben für bearbeitete Übersetzungen ausschließen (standardmäßig aktiviert): Überspringt eine Freigabe, wenn derselbe Benutzer die Zeichenkette bereits übersetzt hat, damit seine Arbeit nicht doppelt gezählt wird. Wenn die Option deaktiviert ist, werden sowohl die Übersetzung als auch die Freigabe gezählt.
- Bestimmte Kategorien für automatische Übersetzungen verwenden (standardmäßig aktiviert): Ordnet Treffer aus der automatischen Übersetzung ihrer Quellkategorie (MT, KI) statt der Standardkategorie Andere Übersetzungen zu. Die Nachbearbeitung von MT- oder KI-Ausgaben erfordert in der Regel einen anderen Aufwand als die Bearbeitung menschlicher Übersetzungen, sodass sich die Kosten damit genauer messen lassen.
- Bearbeitungsdistanz für das TM-Nettotarifschema verwenden (standardmäßig deaktiviert): Ordnet TM-Treffer danach ein, wie stark der Vorschlag bearbeitet wurde, um die endgültige Übersetzung zu erhalten, statt nach der Ähnlichkeit zur Quelle. Dadurch wird der Aufwand für die Nachbearbeitung besser abgebildet. Wenn die Option aktiviert ist, wird der Treffertyp 101 (perfekt) entfernt und TM-Treffer auf 100 begrenzt. Treffer, die vor dem 13. Juli 2026 aufgezeichnet wurden, werden anhand der Quellenähnlichkeit behandelt. Da die Option den Treffertyp 101 (perfekt) entfernt, werden auch perfekte Treffer darunter als 100 gezählt.
Im Bereich Nettotarifschemata kannst du den Prozentsatz des vollständigen Übersetzungstarifs festlegen, der für Übersetzungen und deren Freigaben auf Grundlage verschiedener Treffertypen gezahlt wird.
Da die Option Korrekturlesetarife nach Kategorie verwenden standardmäßig aktiviert ist, hängen die Korrekturlesekosten von der Ursprungskategorie der Übersetzung ab (TM, MT, KI oder Andere).
Unabhängig vom ursprünglichen Trefferprozentsatz der Übersetzung wird ihre Freigabe immer mit der maximalen Trefferquote für diese Kategorie berechnet.
So funktioniert es in der Praxis:
- Teiltreffer: Wenn eine Übersetzung einen 85-%-MT-Treffer aufweist, wird ihre Genehmigung mit dem Tarif 100 / Genehmigung unter der Kategorie MT-Treffer berechnet.
- Übersetzungen von Grund auf (kein Treffer): Wurde eine Übersetzung ohne Vorschläge erstellt, wird ihre Freigabe zum Satz 100 / Freigabe unter der Kategorie Andere Übersetzungen berechnet.
Standardmäßig kannst du den Prozentsatz des vollständigen Übersetzungstarifs für die folgenden Kategorien konfigurieren:
TM-Treffer:
- 101 (perfekt) / Freigabe – für Übersetzungen, die mit TM-Vorschlägen mit perfekter Übereinstimmung erstellt wurden (Quellzeichenketten sind nach Text und Kontext identisch mit dem TM-Vorschlag), sowie für deren Freigaben. Dieser Treffertyp ist nur verfügbar, wenn Bearbeitungsdistanz für das TM-Nettotarifschema verwenden deaktiviert ist.
- 100 / Freigabe – für Übersetzungen, die mit TM-Vorschlägen mit 100-%-Übereinstimmung erstellt wurden (Quellzeichenketten sind nur beim Text mit dem TM-Vorschlag identisch), sowie für Freigaben aller TM-Treffer mit 100 % oder weniger.
MT-Treffer:
- 100 / Freigabe – für Übersetzungen, die mit MT-Vorschlägen mit 100-%-Übereinstimmung erstellt wurden (die gespeicherte Übersetzung stimmt exakt mit dem MT-Vorschlag überein), sowie für alle Freigaben innerhalb der MT-Kategorie.
KI-Treffer:
- 100 / Freigabe – für Übersetzungen, die mit KI-Vorschlägen mit 100-%-Übereinstimmung erstellt wurden (die gespeicherte Übersetzung stimmt exakt mit dem KI-Vorschlag überein), sowie für alle Freigaben innerhalb der KI-Kategorie.
Andere Übersetzungen:
- 100 / Freigabe – für Übersetzungen, die mit vorhandenen Übersetzungen anderer Benutzer erstellt wurden (die gespeicherte Übersetzung stimmt exakt mit der vorhandenen Übersetzung überein), sowie für Freigaben von Übersetzungen, die von Grund auf (kein Treffer) oder mithilfe vorhandener Übersetzungen erstellt wurden.
Wenn mehrere Schemakategorien auf eine Übersetzung angewendet werden können (z. B. wenn eine Zeichenkette eine Kombination aus TM-, MT- oder KI-Vorschlägen und vorhandenen Übersetzungen anderer Benutzer enthält), wird die neue Übersetzung mit dem niedrigsten Wert des Nettotarifschemas berechnet. Wenn eine Zeichenkette beispielsweise einen TM-Treffer von 101 % (perfekt) als Vorschlag hat (10 % des vollständigen Übersetzungstarifs) und einen MT-Treffer von 100 % (5 % des vollständigen Übersetzungstarifs), wird die neue zu dieser Zeichenkette hinzugefügte Übersetzung mit 5 % des vollständigen Übersetzungstarifs berechnet.
Du kannst auch benutzerdefinierte Treffertypen für die Kategorien TM, MT, KI und Andere Übersetzungen hinzufügen und dabei den gewünschten Prozentsatz der Textähnlichkeit sowie den Prozentsatz des vollständigen Übersetzungstarifs festlegen, der für eine solche Übersetzung gezahlt wird.
Um eigene Treffertypen hinzuzufügen, gehe wie folgt vor:
- Klicke in der Kopfzeile des entsprechenden Kategoriebereichs auf .
- Klicke unten im Bereich auf .
- Lege den Trefferbereich und den Prozentsatz des Tarifs für die vollständige Übersetzung fest.
- Klicke erneut auf , um die Einstellungen zu speichern.
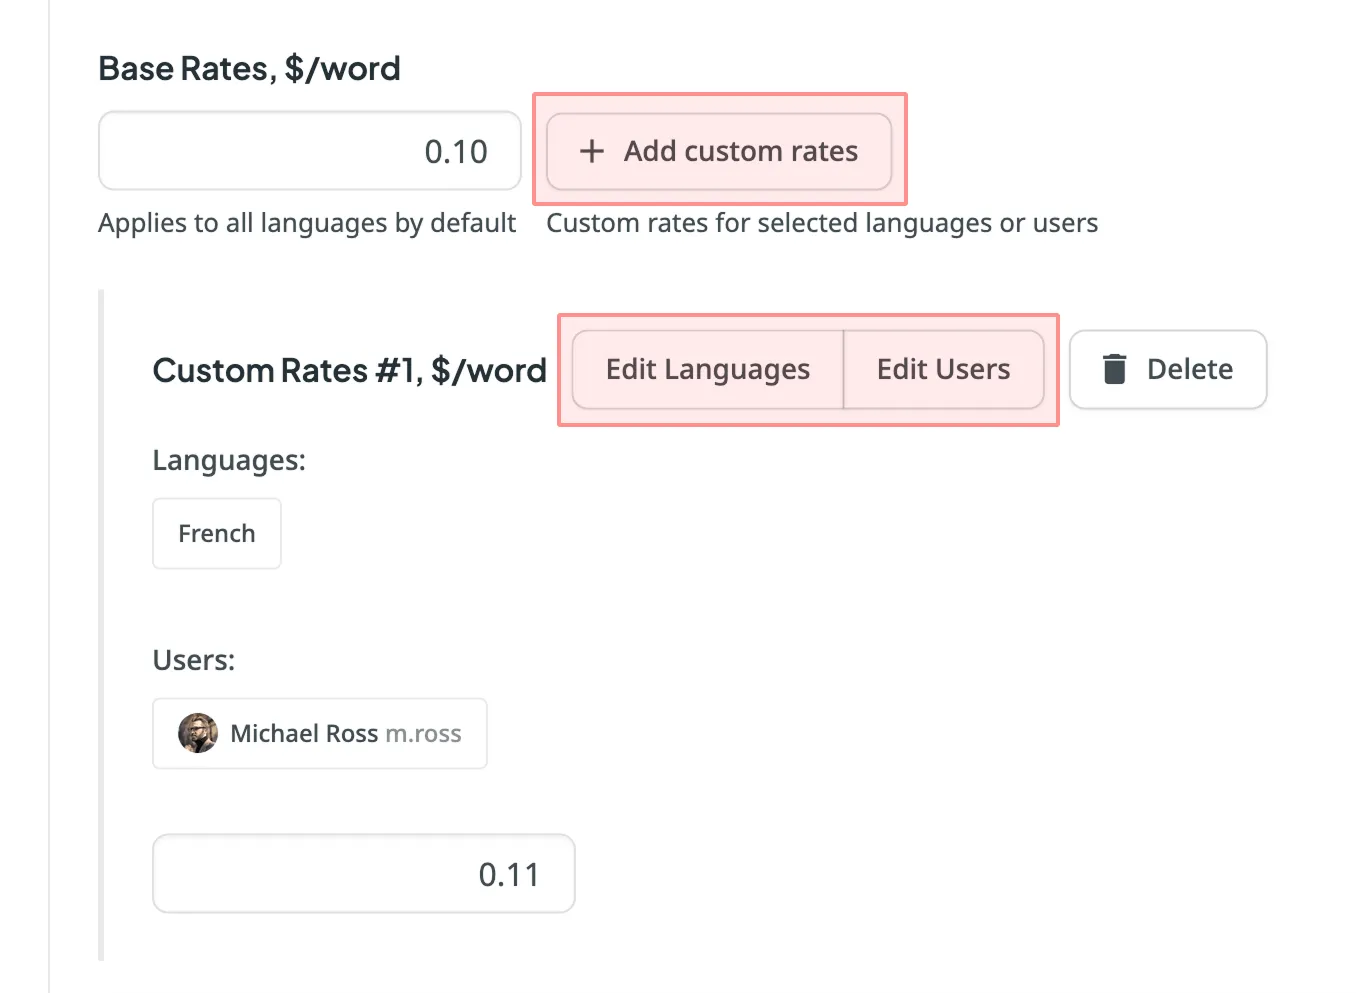
Zusätzlich zum Basistarif, der standardmäßig auf alle Sprachen und Benutzer angewendet wird, kannst du benutzerdefinierte Tarife für bestimmte Sprachen und Benutzer hinzufügen. Um benutzerdefinierte Tarife hinzuzufügen, klicke auf Benutzerdefinierte Tarife hinzufügen.
Um die Sprachen und Benutzer für benutzerdefinierte Tarife auszuwählen, klicke auf Sprachen bearbeiten und Benutzer bearbeiten und wähle die gewünschten aus. Du kannst beliebig viele benutzerdefinierte Tarife erstellen.
Wenn der Übersetzungskostenbericht erstellt wird, zeigt er eine umfassende Aufschlüsselung von Kosten, Einsparungen und Arbeitsarten.
- Gesamt – Die endgültig berechneten Übersetzungs- und Validierungskosten (einschließlich TM-, MT- und KI-Einsparungen, gewichteter Einheiten und automatisch übersetzter Einheiten).
- Gesamtwerte nach Benutzer und Sprache – Unterhalb der Hauptzusammenfassung teilt der Bericht die Daten entsprechend dem ausgewählten Filter Gruppieren nach auf:
- Nach Mitglied gruppieren – Zeigt die Gesamtkosten für jeden einzelnen Übersetzer oder Korrekturleser, mit darunter verschachtelten Sprachzwischensummen.
- Nach Sprache gruppieren – Zeigt die Gesamtkosten für jede Zielsprache, mit darunter verschachtelten Zwischensummen für einzelne Übersetzer oder Korrekturleser.
- Zwischensummen – Detaillierte Metriken für jeden Zielsprachen- oder Benutzerblock:
- Übersetzt & nachbearbeitet – Die Kosten für Übersetzungen.
- Korrekturlesen – die Kosten für Freigaben.
- Einsparungen (TM, MT und KI) – Der finanzielle Betrag, der durch die Nutzung von Übereinstimmungen aus TM, MT oder KI eingespart wurde.
- Gewichtete Wörter / Zeichenketten / Zeichen / Zeichen mit Leerzeichen – die angepasste Anzahl der Einheiten nach Anwendung von Rabattregeln für Wiederholungen und unscharfe Treffer, die den tatsächlichen Übersetzungsaufwand widerspiegelt.
- Automatisch übersetzte Wörter / Strings / Zeichen / Zeichen mit Leerzeichen – Die Gesamtzahl der Einheiten, die bereits durch automatische Übersetzung ausgefüllt wurden.
In jedem Benutzer- oder Sprachbereich erstellt der Bericht eine Aufschlüsselungstabelle mit den folgenden Spalten:
- Treffertyp – die auf den Text angewendete spezifische Kategorie und der Prozentsatzbereich.
- Beigesteuerte Wörter / Strings / Zeichen / Zeichen mit Leerzeichen – Die rohe Anzahl der Einheiten, die innerhalb dieses spezifischen Zeilentyps verarbeitet wurden.
- Gewichtete Wörter / Zeichenketten / Zeichen / Zeichen mit Leerzeichen – das angepasste Einheitenvolumen auf Grundlage deiner Regeln für das Nettotarifschema.
- Tarif pro Einheit – der konkrete Preis, der pro einzelner Einheit für diesen Treffer- oder Freigabetyp gezahlt wird.
- Preis – Die Gesamtkosten für diese Zeile, berechnet anhand der Anzahl der Einheiten und des zugewiesenen Satzes.
Standardmäßig werden bei aktivierter Option Korrekturlesetarife nach Kategorie verwenden alle Übersetzungen und Genehmigungen nach ihrer Ursprungskategorie gruppiert. Eine separate Korrekturlesetabelle wird nicht angezeigt. Stattdessen erscheinen Genehmigungen als Zeilen innerhalb der jeweiligen Übereinstimmungsblöcke:
- Kein Treffer – Von Grund auf übersetzte Einheiten ohne Nutzung von TM, MT oder KI (berechnet mit dem vollständigen Übersetzungstarif).
- TM-Treffer – Einheiten, die mit dem Translation Memory übereinstimmen. Dies umfasst separate Zeilen für Übersetzungen (z. B.
101 % (perfekt),100 %,99–85 %) und die jeweiligen Genehmigungen (z. B.Genehmigung 101 % (perfekt),Genehmigung 100 %). - MT-Treffer – Einheiten, die mit Machine-Translation-Engines übereinstimmen. Enthält Zeilen für Übersetzungen (z. B.
100 %,99–94 %) und eine eigene ZeileGenehmigungfür Validierungen in dieser Kategorie. - KI-Treffer – Einheiten, die mit KI-Vorschlägen übereinstimmen. Enthält Zeilen für Übersetzungen (z. B.
100 %,99–94 %) und eine eigene ZeileGenehmigungfür Validierungen in dieser Kategorie. - Übereinstimmung mit anderen Übersetzungen – Einheiten, die mit vorhandenen Übersetzungen anderer Benutzer übereinstimmen. Enthält Zeilen für Übersetzungen (z. B.
100 %,99–94 %) und eine eigene ZeileGenehmigungfür Validierungen in dieser Kategorie. - Gesamt – Fasst alle übersetzten, gewichteten und genehmigten Einheiten für diesen Bereich zusammen.
Um den Übersetzungskostenbericht zur Offline-Analyse oder Buchhaltung herunterzuladen, klicken Sie auf Exportieren und wählen Sie das gewünschte Format (CSV, XLSX oder JSON).
Genauigkeit der automatischen Übersetzung
Abschnitt betitelt „Genauigkeit der automatischen Übersetzung“Verwende diesen Bericht, um die Übersetzungsqualität der in deinem Projekt verwendeten Methoden zur automatischen Übersetzung (KI, MT und TM) zu bewerten und die effizientesten zu ermitteln.
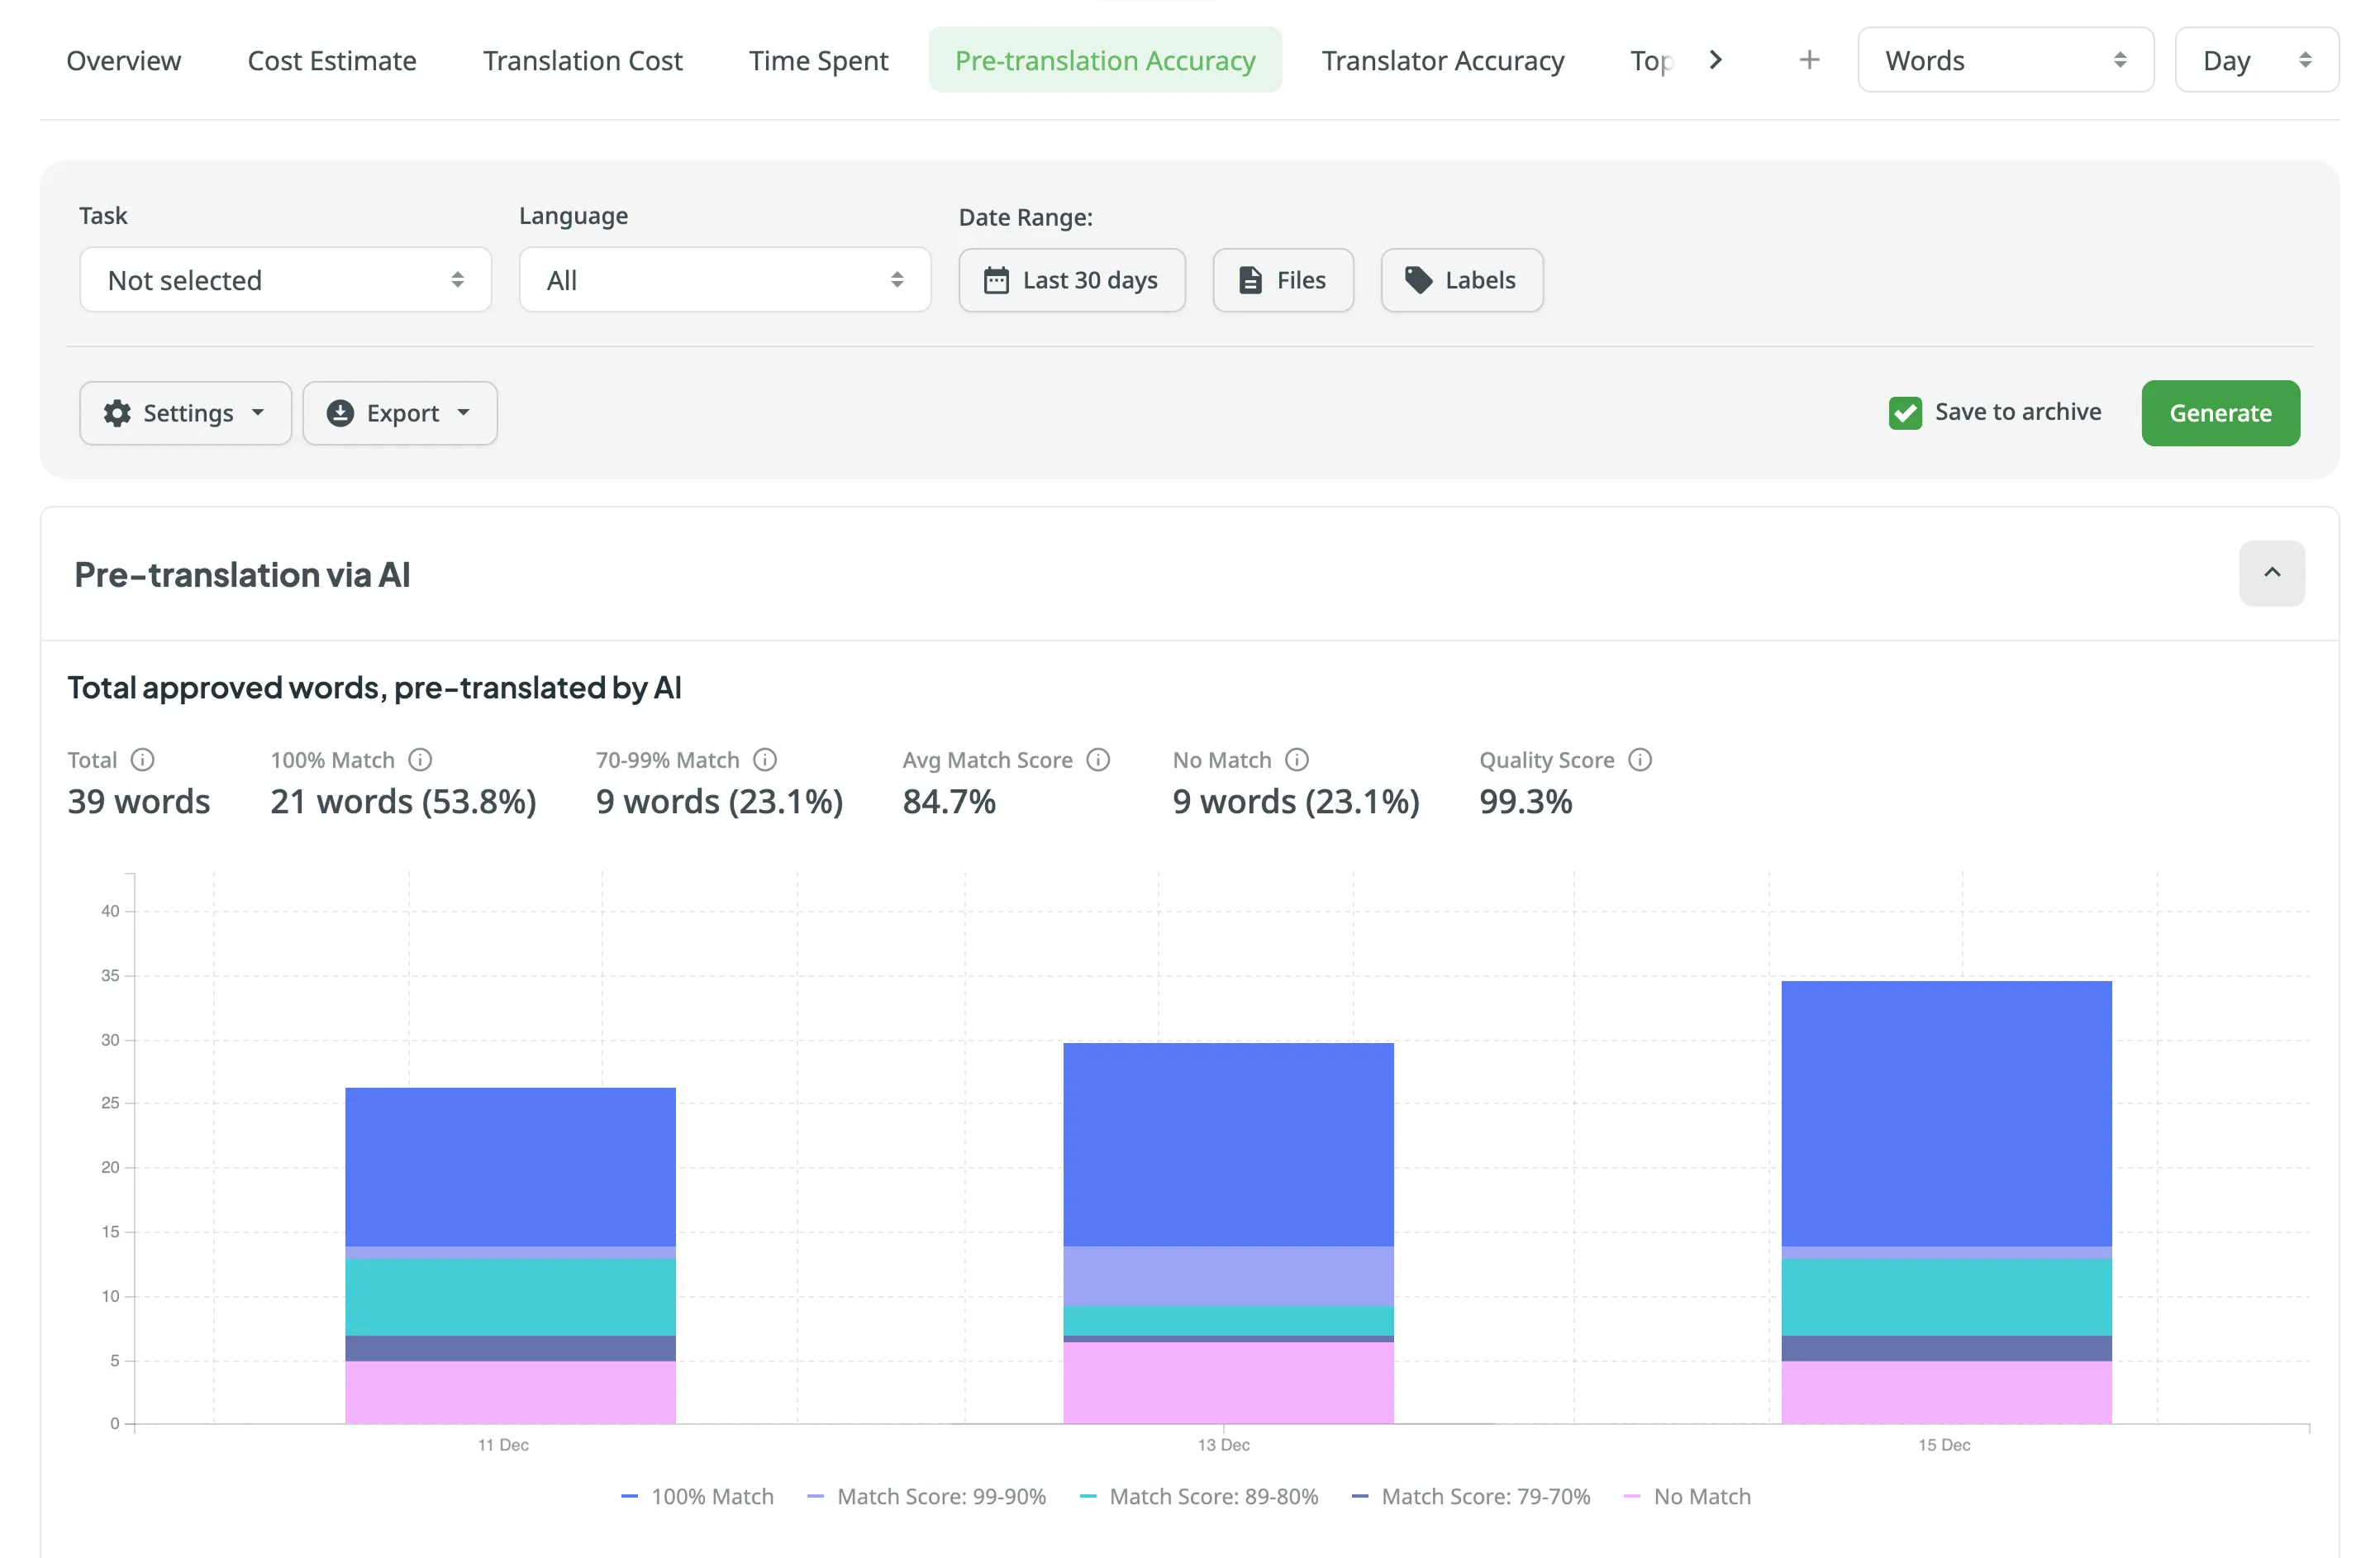
Dieser Bericht analysiert den erforderlichen Nachbearbeitungsaufwand für automatisch übersetzte Strings. Er vergleicht die ursprüngliche automatische Übersetzung mit der endgültig genehmigten Übersetzung, um einen Match-Score zu berechnen. Dies hilft dir dabei zu erkennen, welche KI-Prompts oder MT-Engines den geringsten manuellen Bearbeitungsaufwand erfordern, sodass du deinen Workflow anpassen und die Nutzung der leistungsstärksten Methoden erhöhen kannst.
Die Kennzahl „Match-Score“ wird auf Zeichenebene berechnet. Die von dir ausgewählte Berichtseinheit (Strings, Wörter, Zeichen oder Zeichen mit Leerzeichen) bestimmt, wie die Ergebnisse angezeigt werden (wenn du z. B. Strings auswählst, wird der gesamte Ausgangsstring anhand seines Gesamtwerts in eine Kategorie eingeordnet).
- Es werden nur Ausgangsstrings berücksichtigt, für die über eine automatische Übersetzung eine Übersetzung hinzugefügt und anschließend genehmigt wurde.
- Der Bericht berücksichtigt automatische Übersetzungen, die innerhalb des ausgewählten Zeitraums hinzugefügt wurden, unabhängig davon, wann sie genehmigt wurden.
- Wenn für einen String mehrere automatische Übersetzungen vorhanden sind, wird jede mit ihrem Match-Score berücksichtigt.
Um aus diesem Bericht möglichst verwertbare Erkenntnisse zu gewinnen, empfehlen wir folgenden Ablauf:
- Automatisch übersetzen – Wende auf deinen Ausgangsinhalt eine automatische Übersetzung mithilfe von KI, MT oder TM an.
- Nachbearbeiten & genehmigen – Lass deine Korrekturleser die automatisch übersetzten Strings überprüfen. Sie sollten Fehler oder stilistische Probleme korrigieren (Nachbearbeitung) und die endgültigen Versionen genehmigen.
- Genauigkeit messen – Erstelle den Bericht zur Genauigkeit der automatischen Übersetzung.
- Optimieren – Ermittle, welcher KI-Prompt, welche MT-Engine oder welches TM den geringsten manuellen Bearbeitungsaufwand erforderte. Aktualisiere deinen Workflow, damit diese leistungsstarke Methode für zukünftige Übersetzungen verwendet wird.
Du kannst einen Bericht zur Genauigkeit der automatischen Übersetzung anhand der folgenden Filter erstellen:
- Aufgabe: Nicht ausgewählt, alle Aufgaben oder eine bestimmte Aufgabe (nur verfügbar, wenn das Projekt Aufgaben enthält).
- Sprache: Alle oder eine bestimmte Sprache.
- Datumsbereich: Heute, Gestern, Letzte 7 Tage, Letzte 30 Tage, Dieser Monat, Letzter Monat, Gesamter Zeitraum oder benutzerdefinierter Zeitraum. Dieser Filter wählt den Zeitraum aus, in dem die Strings automatisch übersetzt wurden.
- Dateien: Alle Dateien oder ausgewählte Dateien.
- Labels: Nicht ausgewählt, Strings mit ausgewählten Labels oder Strings ohne ausgewählte Labels (nur verfügbar, wenn das Projekt Labels enthält).
Zusätzlich kannst du unter den Einstellungen des Berichts Match-Score-Kategorien konfigurieren. Diese Einstellungen legen fest, wie das Diagramm bearbeitete Übersetzungen gruppiert. Wenn du beispielsweise eine Kategorie für 99–90 % festlegst, werden Ausgangsstrings, bei denen die genehmigte Übersetzung innerhalb dieses Bereichs mit der automatischen Übersetzung übereinstimmt, zusammengefasst. Alles unterhalb deiner niedrigsten definierten Trefferkategorie wird als Kein Treffer (neue Übersetzung) behandelt.
Um den Bericht zur Genauigkeit der automatischen Übersetzung zu erstellen, gehe wie folgt vor:
- Wähle die gewünschte Berichtseinheit aus (Wörter, Strings, Zeichen oder Zeichen mit Leerzeichen).
- Wähle die gewünschte Gruppierung der Histogrammdaten aus (Tag oder Monat).
- Bei der Gruppierung nach Tag enthält das gestapelte Histogramm mehr Balken und bietet eine detailliertere Ansicht für jeden einzelnen Tag.
- Bei der Gruppierung nach Monat werden die Daten in weniger, dafür breiteren Monatssegmenten angezeigt.
- (Optional) Wähle die Aufgabe aus, wenn du einen Bericht auf Grundlage der Arbeit innerhalb aller oder bestimmter Aufgaben erstellen möchtest. Alternativ kannst du Nicht ausgewählt beibehalten, um einen Bericht auf Grundlage eines größeren Inhaltsumfangs zu erstellen.
- Wähle die gewünschte Sprache aus.
- Wähle den Datumsbereich aus.
- (Optional) Wähle Dateien aus, um den Ausgangsinhalt festzulegen. Du kannst Alle Dateien oder Ausgewählte Dateien auswählen.
- (Optional) Wähle Labels aus, um Strings anhand ihrer Labels zu filtern. Du kannst Strings mit ausgewählten Labels oder Strings ohne ausgewählte Labels auswählen.
- (Optional) Deaktiviere Im Archiv speichern, wenn du den Bericht nicht im Archiv speichern möchtest.
- Klicke auf Einstellungen, um deine Match-Score-Kategorien zu konfigurieren.
- Klicke auf Generieren.
Nach der Erstellung des Berichts werden die Informationen nach Methoden der automatischen Übersetzung gruppiert (über KI, MT und TM):
- Automatische Übersetzung über KI:
- Gesamtzahl der genehmigten Wörter, die automatisch durch KI übersetzt wurden
- Separate Diagramme für jeden Prompt (maximal 10 angezeigte Prompts)
- Automatische Übersetzung über MT:
- Gesamtzahl der genehmigten Wörter, die automatisch durch MT übersetzt wurden
- Separate Diagramme für jede MT-Engine (maximal 10 angezeigte Engines)
- Automatische Übersetzung über TM:
- Gesamtzahl der genehmigten Wörter, die automatisch durch TM übersetzt wurden
Jeder Abschnitt zeigt den Umfang des Ausgangsinhalts, aufgeschlüsselt nach den folgenden wichtigen Kennzahlen. (Für diese Erklärung gehen wir davon aus, dass die Berichtseinheit Strings ausgewählt wurde):
- Gesamt – Die Gesamtzahl der Ausgangsstrings, denen durch automatische Übersetzung Übersetzungen hinzugefügt und die anschließend genehmigt wurden. Dazu gehören sowohl ohne Änderungen genehmigte Strings als auch Strings, bei denen ein Korrekturleser eine korrigierte Übersetzung hinzugefügt hat, die anschließend genehmigt wurde.
- 100-%-Treffer – Die Anzahl der Ausgangsstrings, bei denen die genehmigte Übersetzung exakt mit der über die automatische Übersetzung hinzugefügten Übersetzung übereinstimmt (100 %).
- Match-Score-Bereiche (z. B. 70–99-%-Treffer) – Die Anzahl der Ausgangsstrings, bei denen die genehmigte Übersetzung innerhalb des konfigurierten Prozentbereichs mit der automatischen Übersetzung übereinstimmt. Dies zeigt an, dass ein Korrekturleser die automatische Übersetzung bearbeitet hat, die endgültig genehmigte Version jedoch der ursprünglichen Empfehlung weiterhin ähnlich ist.
- Durchschn. Match-Score – Der durchschnittliche Prozentsatz der Ähnlichkeit zwischen den ursprünglichen automatischen Übersetzungen und den endgültig genehmigten Texten. Ein höherer Prozentsatz bedeutet, dass die automatischen Übersetzungen genauer waren und weniger Bearbeitungen erforderten.
- Kein Treffer – Die Anzahl der Ausgangsstrings, bei denen die genehmigte Übersetzung stärker von der automatischen Übersetzung abweicht als der niedrigste Prozentsatz in deinen konfigurierten Match-Score-Kategorien. In diesen Fällen wurde die Übersetzung beim Korrekturlesen so stark geändert, dass sie als vollständige Neufassung (neue Übersetzung) behandelt wird.
- Qualitätswert – Misst die Gesamtqualität anhand des durchschnittlichen Match-Scores, der für die übersetzten Inhalte erreicht wurde. Er wird wie folgt berechnet:
100 - ((Unedited + (Edited * (100 - Avg. Match Score))) / Total)
Das gestapelte Histogramm unter den Kennzahlen visualisiert die Verteilung dieser Kategorien im Zeitverlauf. Jeder Balken stellt den Umfang der verarbeiteten Quelleneinheiten dar, aufgeschlüsselt nach ihrer Qualitätskategorie (z. B. 100-%-Treffer, Match-Score: 99–90 %, Kein Treffer).
Um den Bericht zur Genauigkeit der automatischen Übersetzung herunterzuladen, klicke auf Exportieren und wähle das gewünschte Exportformat (CSV, XLSX oder JSON).
Verwende diesen Bericht, um die Übersetzungsqualität einzelner Übersetzer in deinem Projekt zu bewerten und besonders leistungsstarke Übersetzer zu ermitteln.
Dieser Bericht analysiert den erforderlichen Nachbearbeitungsaufwand für von menschlichen Übersetzern eingereichte Übersetzungen. Er vergleicht die ursprüngliche Übersetzung jedes Übersetzers mit der endgültig genehmigten Version, um einen Match-Score zu berechnen. Dies hilft dir, Übersetzer zu identifizieren, die konstant hochwertige Arbeit mit nur minimalen Korrekturen liefern, sowie solche, die von zusätzlicher Anleitung oder Schulung profitieren könnten.
Die Kennzahl „Match-Score“ wird auf Zeichenebene berechnet. Die ausgewählte Berichtseinheit (Strings, Wörter oder Zeichen) bestimmt, wie die Ergebnisse angezeigt werden (wenn du z. B. Strings auswählst, wird der gesamte Ausgangsstring anhand seines Gesamtwerts in eine Kategorie eingeordnet).
- Es werden nur Ausgangsstrings berücksichtigt, für die ein menschlicher Übersetzer eine Übersetzung eingereicht hat, die anschließend genehmigt wurde.
- Der Bericht berücksichtigt Übersetzungen, die innerhalb des ausgewählten Zeitraums hinzugefügt wurden, unabhängig davon, wann sie genehmigt wurden.
- Wenn für einen String mehrere Übersetzungen vorhanden sind, wird jede mit ihrem Match-Score berücksichtigt.
Um aus diesem Bericht möglichst verwertbare Erkenntnisse zu gewinnen, empfehlen wir folgenden Ablauf:
- Übersetzen – Lass deine Übersetzer die Projektinhalte übersetzen.
- Korrekturlesen & genehmigen – Lass deine Korrekturleser die Übersetzungen überprüfen. Sie sollten Fehler oder stilistische Probleme korrigieren (Nachbearbeitung) und die endgültigen Versionen genehmigen.
- Genauigkeit messen – Erstelle den Bericht zur Übersetzergenauigkeit, um zu sehen, wie stark die Korrekturleser die Arbeit der einzelnen Übersetzer bearbeiten mussten.
- Feedback – Nutze die Ergebnisse, um gezieltes Feedback zu geben. Übersetzer mit hohen 100-%-Treffer-Raten gehören zu den besonders leistungsstarken Übersetzern, während hohe Kein Treffer-Raten auf einen höheren Bedarf an Beachtung von Glossaren oder an Schulungen zu Styleguides hindeuten können.
Du kannst einen Bericht zur Übersetzergenauigkeit anhand der folgenden Filter erstellen:
- Benutzer: Alle oder ausgewählte Benutzer.
- Sprache: Alle oder eine bestimmte Sprache.
- Datumsbereich: Heute, Gestern, Letzte 7 Tage, Letzte 30 Tage, Dieser Monat, Letzter Monat, Gesamter Zeitraum oder benutzerdefinierter Zeitraum. Dieser Filter wählt den Zeitraum aus, in dem die Übersetzungen hinzugefügt wurden.
- Dateien: Alle Dateien oder ausgewählte Dateien.
- Labels: Nicht ausgewählt, Strings mit ausgewählten Labels oder Strings ohne ausgewählte Labels (nur verfügbar, wenn das Projekt Labels enthält).
Zusätzlich kannst du unter den Einstellungen des Berichts Match-Score-Kategorien konfigurieren. Diese Einstellungen legen fest, wie das Diagramm bearbeitete Übersetzungen gruppiert. Wenn du beispielsweise eine Kategorie für 99–90 % festlegst, werden Ausgangsstrings, bei denen die genehmigte Übersetzung innerhalb dieses Bereichs mit der ursprünglichen Übersetzung übereinstimmt, zusammengefasst. Alles unterhalb deiner niedrigsten definierten Trefferkategorie wird als Kein Treffer (neue Übersetzung) behandelt.
Um den Bericht zur Übersetzergenauigkeit zu erstellen, gehe wie folgt vor:
- Wähle die gewünschte Berichtseinheit aus (Wörter, Strings, Zeichen oder Zeichen mit Leerzeichen).
- (Optional) Wähle einen oder mehrere Benutzer aus, wenn du den Bericht nur für bestimmte Übersetzer erstellen möchtest. Andernfalls wähle Alle aus, um alle einzubeziehen.
- Wähle die gewünschte Sprache oder Alle, wenn du jede Zielsprache einbeziehen möchtest.
- Wähle den Datumsbereich aus.
- (Optional) Wähle Dateien aus, um den Ausgangsinhalt festzulegen. Du kannst Alle Dateien oder Ausgewählte Dateien auswählen.
- (Optional) Wähle Labels aus, um Strings anhand ihrer Labels zu filtern. Du kannst Strings mit ausgewählten Labels oder Strings ohne ausgewählte Labels auswählen.
- (Optional) Deaktiviere Im Archiv speichern, wenn du den Bericht nicht im Archiv speichern möchtest.
- Klicke auf Einstellungen, um deine Match-Score-Kategorien zu konfigurieren.
- Klicke auf Generieren.
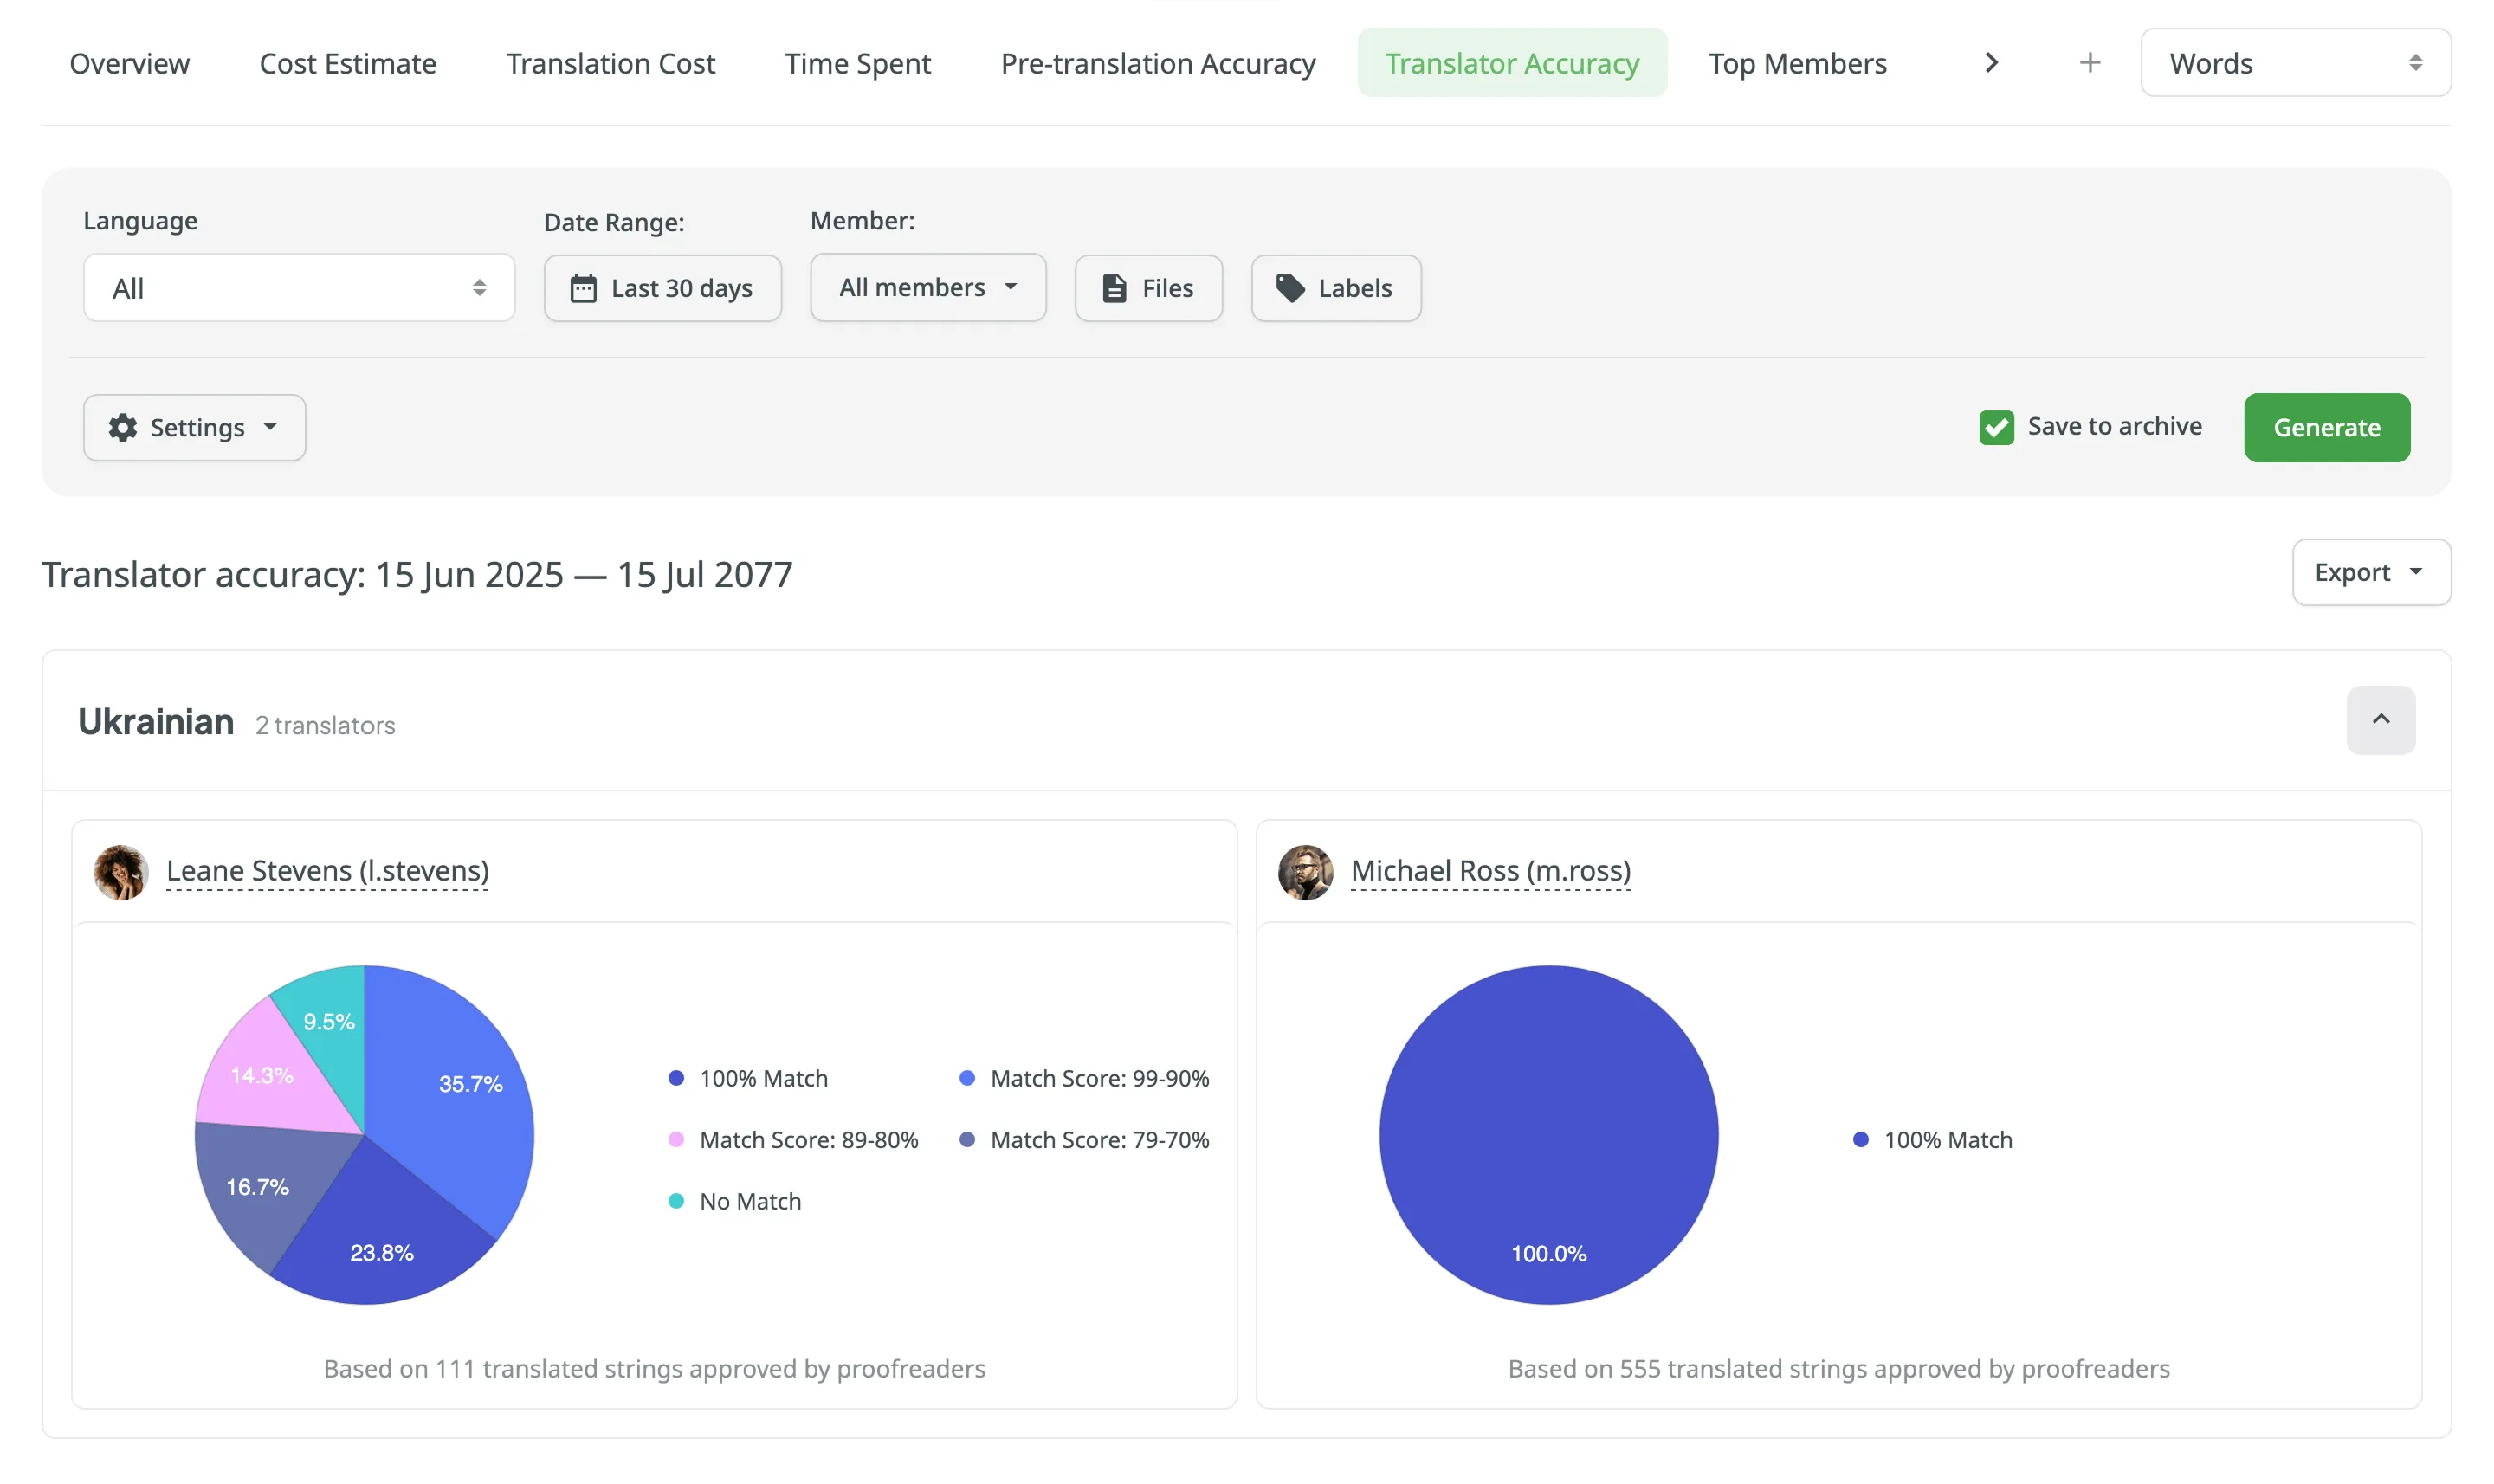
Nach der Erstellung des Berichts werden die Informationen nach Sprache gruppiert, und jeder Übersetzer wird mit seinen individuellen Statistiken aufgeführt.
In jedem Abschnitt werden die Daten als Kreisdiagramm dargestellt. Das Diagramm visualisiert den Anteil des Ausgangsinhalts basierend darauf, wie stark die ursprüngliche Arbeit des Übersetzers mit der endgültig genehmigten Version übereinstimmte:
- 100-%-Treffer – Die Anzahl der Quelleneinheiten, bei denen die genehmigte Übersetzung exakt mit der ursprünglichen Übersetzung des Übersetzers übereinstimmt (ohne Bearbeitungen genehmigt).
- Match-Score-Bereiche (z. B. 99–90-%-Treffer) – Die Anzahl der Quelleneinheiten, bei denen die genehmigte Übersetzung eine bearbeitete Version der Arbeit des Übersetzers ist, aber innerhalb des konfigurierten Prozentbereichs ähnlich bleibt.
- Kein Treffer – Die Anzahl der Quelleneinheiten, bei denen die genehmigte Übersetzung deutlich von der ursprünglichen Arbeit des Übersetzers abweicht (unterhalb der niedrigsten konfigurierten Treffertenkategorie). In diesen Fällen wurde die Übersetzung beim Korrekturlesen so stark geändert, dass sie als vollständige Neufassung (neue Übersetzung) behandelt wird.
Um den Bericht zur Übersetzergenauigkeit herunterzuladen, klicke auf Exportieren und wähle das gewünschte Exportformat (CSV, XLSX oder JSON).
Verwende diesen Bericht, um die Arbeitskosten anhand der Zeit zu berechnen, die Mitwirkende für Aufgaben aufwenden. Dieser Bericht ist besonders nützlich, wenn Übersetzer und Korrekturleser nach Stunden statt nach dem Inhaltsumfang (z. B. Wörtern) bezahlt werden.
Der Bericht verwendet die von Mitwirkenden erfasste Zeit direkt in den Kommentaren einer Aufgabe.
Du kannst einen Bericht zum Zeitaufwand anhand der folgenden Filterparameter erstellen:
- Aufgabe: Nicht ausgewählt, alle Aufgaben oder mehrere bestimmte Aufgaben.
- Datumsbereich: Heute, Gestern, Letzte 7 Tage, Letzte 30 Tage, Dieser Monat, Letzter Monat, Gesamter Zeitraum oder benutzerdefinierter Zeitraum.
- Sprache: Alle oder eine bestimmte Zielsprache.
- Mitglied: Alle oder bestimmte Mitglieder.
- Aufgabentyp: Alle, Mit eigenen Übersetzern übersetzen, Mit eigenen Korrekturlesern Korrektur lesen, Mit Anbieter übersetzen oder Mit Anbieter Korrektur lesen.
- Gruppieren nach: Mitglied, Sprache oder Aufgabe.
Um den Bericht zum Zeitaufwand zu erstellen, gehe wie folgt vor:
- Wähle die gewünschte Währung aus.
- Lege deine Tarife fest.
- Verwende die verfügbaren Filterparameter, um die Berichtsdaten festzulegen, die dich interessieren.
- (Optional) Deaktiviere Im Archiv speichern, wenn du den Bericht nicht im Archiv speichern möchtest.
- Klicke auf Generieren.
Du kannst die Stundensätze für die von Mitwirkenden im Projekt geleistete Arbeit festlegen. Im Gegensatz zum Bericht Übersetzungskosten ist die Einheit für den Bericht Zeitaufwand fest auf Stunde eingestellt.
Im Bereich Basistarif kannst du den Stundensatz festlegen, der auf alle im Projekt ausgeführten Arbeitsarten (Übersetzen und Korrekturlesen) angewendet wird. Dieser Tarif dient als Standard für alle Sprachen und Mitglieder.
Zusätzlich zum Basistarif, der standardmäßig auf alle Sprachen und Benutzer angewendet wird, kannst du benutzerdefinierte Tarife für bestimmte Sprachen und Benutzer hinzufügen. Um benutzerdefinierte Tarife hinzuzufügen, klicke auf Benutzerdefinierte Tarife hinzufügen.
Um die Sprachen und Benutzer für benutzerdefinierte Tarife auszuwählen, klicke auf Sprachen bearbeiten und Benutzer bearbeiten und wähle die gewünschten aus. Du kannst beliebig viele benutzerdefinierte Tarife erstellen.
Wenn du mit mehreren Tarifkonfigurationen arbeiten möchtest, speichere sie als Vorlagen, indem du auf Speichern unter > Neue Tarifvorlage klickst. Gib anschließend den Vorlagennamen ein und klicke auf Speichern.
Klicke auf Vorlagen, um deine gespeicherten Tarifvorlagen anzuzeigen und zu verwalten.
Bei der Erstellung des Berichts Zeitaufwand werden die folgenden Details angezeigt:
- Gesamt – Die für den ausgewählten Zeitraum berechneten Gesamtkosten und der gesamte Zeitaufwand.
- Gesamtergebnisse nach Benutzer/Sprache/Aufgabe – Der Bericht zeigt je nach ausgewähltem Filter Gruppieren nach die Gesamtergebnisse für jedes Mitglied, jede Sprache oder jede Aufgabe.
Unter der Zusammenfassung zeigt der Bericht eine detaillierte Aufschlüsselung in Tabellenform:
- Sprache – Die Zielsprache der ausgeführten Arbeit.
- Zeitaufwand – Die vom Mitwirkenden für die Arbeit in dieser Sprache erfasste Gesamtzeit.
- Stundensatz – Der angewendete Stundensatz (basierend auf deinem konfigurierten Basistarif und benutzerdefinierten Tarifen).
- Preis – Die für die Arbeit in dieser Sprache berechneten Gesamtkosten.
Um den Bericht Zeitaufwand herunterzuladen, klicke auf Exportieren und wähle das gewünschte Exportformat (CSV, XLSX oder JSON) zur weiteren Analyse oder Dokumentation aus.
Zusätzlich zum Bericht zu den Übersetzungskosten, der auf den Beitragsrohdaten basiert und nach Sprachen gruppiert ist, kannst du diese detaillierten Beitragsrohdaten über die Option Bericht erstellen (Schema für Beitragsrohdaten) oder über die im Crowdin Store verfügbare App Raw Report Data abrufen. Damit kannst du deinen eigenen benutzerdefinierten Bericht entsprechend deinen spezifischen Anforderungen erstellen.
Der Bericht mit Beitragsrohdaten enthält abhängig vom ausgewählten Modus (Übersetzungen, Genehmigungen oder Abstimmungen) verschiedene Spalten. Jede Spalte liefert spezifische Informationen, z. B. source string text hash, die nützlich sind, um Änderungen an Quellstrings trotz derselben stringId zu erkennen. Beachte, dass für dieselbe stringId mehrere Datensätze existieren können, wenn sich Quell-Hash oder Pluralform unterscheiden.
Bei wiederholten Übersetzungen desselben Benutzers für denselben Ausgangsstring, in dieselbe Zielsprache und dieselbe Pluralform sowie unverändertem Quelltext werden in der Berichtstatistik nur die Spalten translationId, targetUnits und updatedAt aktualisiert. Gelöschte Übersetzungen werden ebenfalls mitgezählt. Wenn du diese Spalten verstehst, kannst du die Rohdaten besser interpretieren und deinen Lokalisierungsprozess optimieren.
Die verfügbaren Berichtsspalten und ihre Anwendbarkeit je Modus (d. h. Übersetzungen, Genehmigungen und Abstimmungen) findest du in der folgenden Tabelle:
| Name | Im Berichtsmodus verfügbar | Beschreibung |
|---|---|---|
userId | Übersetzungen, Freigaben, Abstimmungen | Typ: Numerische Kennung eines Benutzers, der eine Übersetzung hinzugefügt hat. |
languageId | Übersetzungen, Freigaben, Abstimmungen | Typ: Kennung der Zielsprache (Crowdin-Sprachcode (z. B. uk)). |
stringId | Übersetzungen, Freigaben, Abstimmungen | Typ: Numerische String-Kennung im Crowdin-Projekt. |
translationId | Übersetzungen, Freigaben, Abstimmungen | Typ: Numerische Kennung der Übersetzung im Crowdin-Projekt. |
fileId | Übersetzungen, Freigaben, Abstimmungen | Typ: Numerische Datei-Kennung im Crowdin-Projekt, in dem der Quell-String gespeichert ist. |
filePath | Übersetzungen, Freigaben, Abstimmungen | Typ: Pfad zur Datei, die den Quell-String enthält (z. B. /main/docs/index.md). |
pluralForm | Übersetzungen, Freigaben, Abstimmungen | Typ: Pluralform der Übersetzung (jede Pluralform wird als einzelner Datensatz im Bericht angezeigt). |
sourceStringTextHash | Übersetzungen, Freigaben, Abstimmungen | Typ: Hash des Quell-Strings. |
mtEngine | Übersetzungen, Freigaben, Abstimmungen | Typ: Name der MT-Engine, von der eine Übersetzung bereitgestellt wurde. |
mtId | Übersetzungen, Freigaben, Abstimmungen | Typ: Numerische MT-Engine-Kennung. |
tmName | Übersetzungen, Freigaben, Abstimmungen | Typ: Name des Translation Memorys, von dem eine Übersetzung bereitgestellt wurde. |
tmId | Übersetzungen, Freigaben, Abstimmungen | Typ: Numerische Translation-Memory-Kennung. |
preTranslated | Übersetzungen, Freigaben, Abstimmungen | Typ: Gibt an, ob eine Übersetzung via Auto-Übersetzung angewendet wurde. |
tmMatch | Übersetzungen | Typ: Der höchste Übereinstimmungswert der Übersetzung mit anderen TM-Vorschlägen, falls vorhanden. |
mtMatch | Übersetzungen | Typ: Der höchste Übereinstimmungswert der Übersetzung mit anderen MT-Vorschlägen, falls vorhanden. |
suggestionMatch | Übersetzungen | Typ: Der höchste Übereinstimmungswert der Übersetzung mit Vorschlägen anderer Übersetzer, falls vorhanden. |
sourceUnits | Übersetzungen, Genehmigungen, Stimmen | Typ: Gibt die Anzahl der Wörter im Quelltext an (nur verfügbar, wenn der Einheitstyp |
targetUnits | Übersetzungen, Genehmigungen, Stimmen | Typ: Gibt die Anzahl der Wörter in der Übersetzung an (nur verfügbar, wenn der Einheitstyp |
createdAt | Übersetzungen, Genehmigungen, Stimmen | Typ: Gibt das Datum an, an dem der String ursprünglich übersetzt wurde. |
updatedAt | Übersetzungen, Genehmigungen, Stimmen | Typ: Gibt das Datum an, an dem die letzte Übersetzung hinzugefügt wurde. |
mark | Stimmen | Typ: Eine Bewertungsmarkierung, die angibt, wie sich die Übersetzungsbewertung geändert hat (z. B. ob eine Übersetzung hoch- oder runtergewertet oder die Bewertung aufgehoben wurde). |
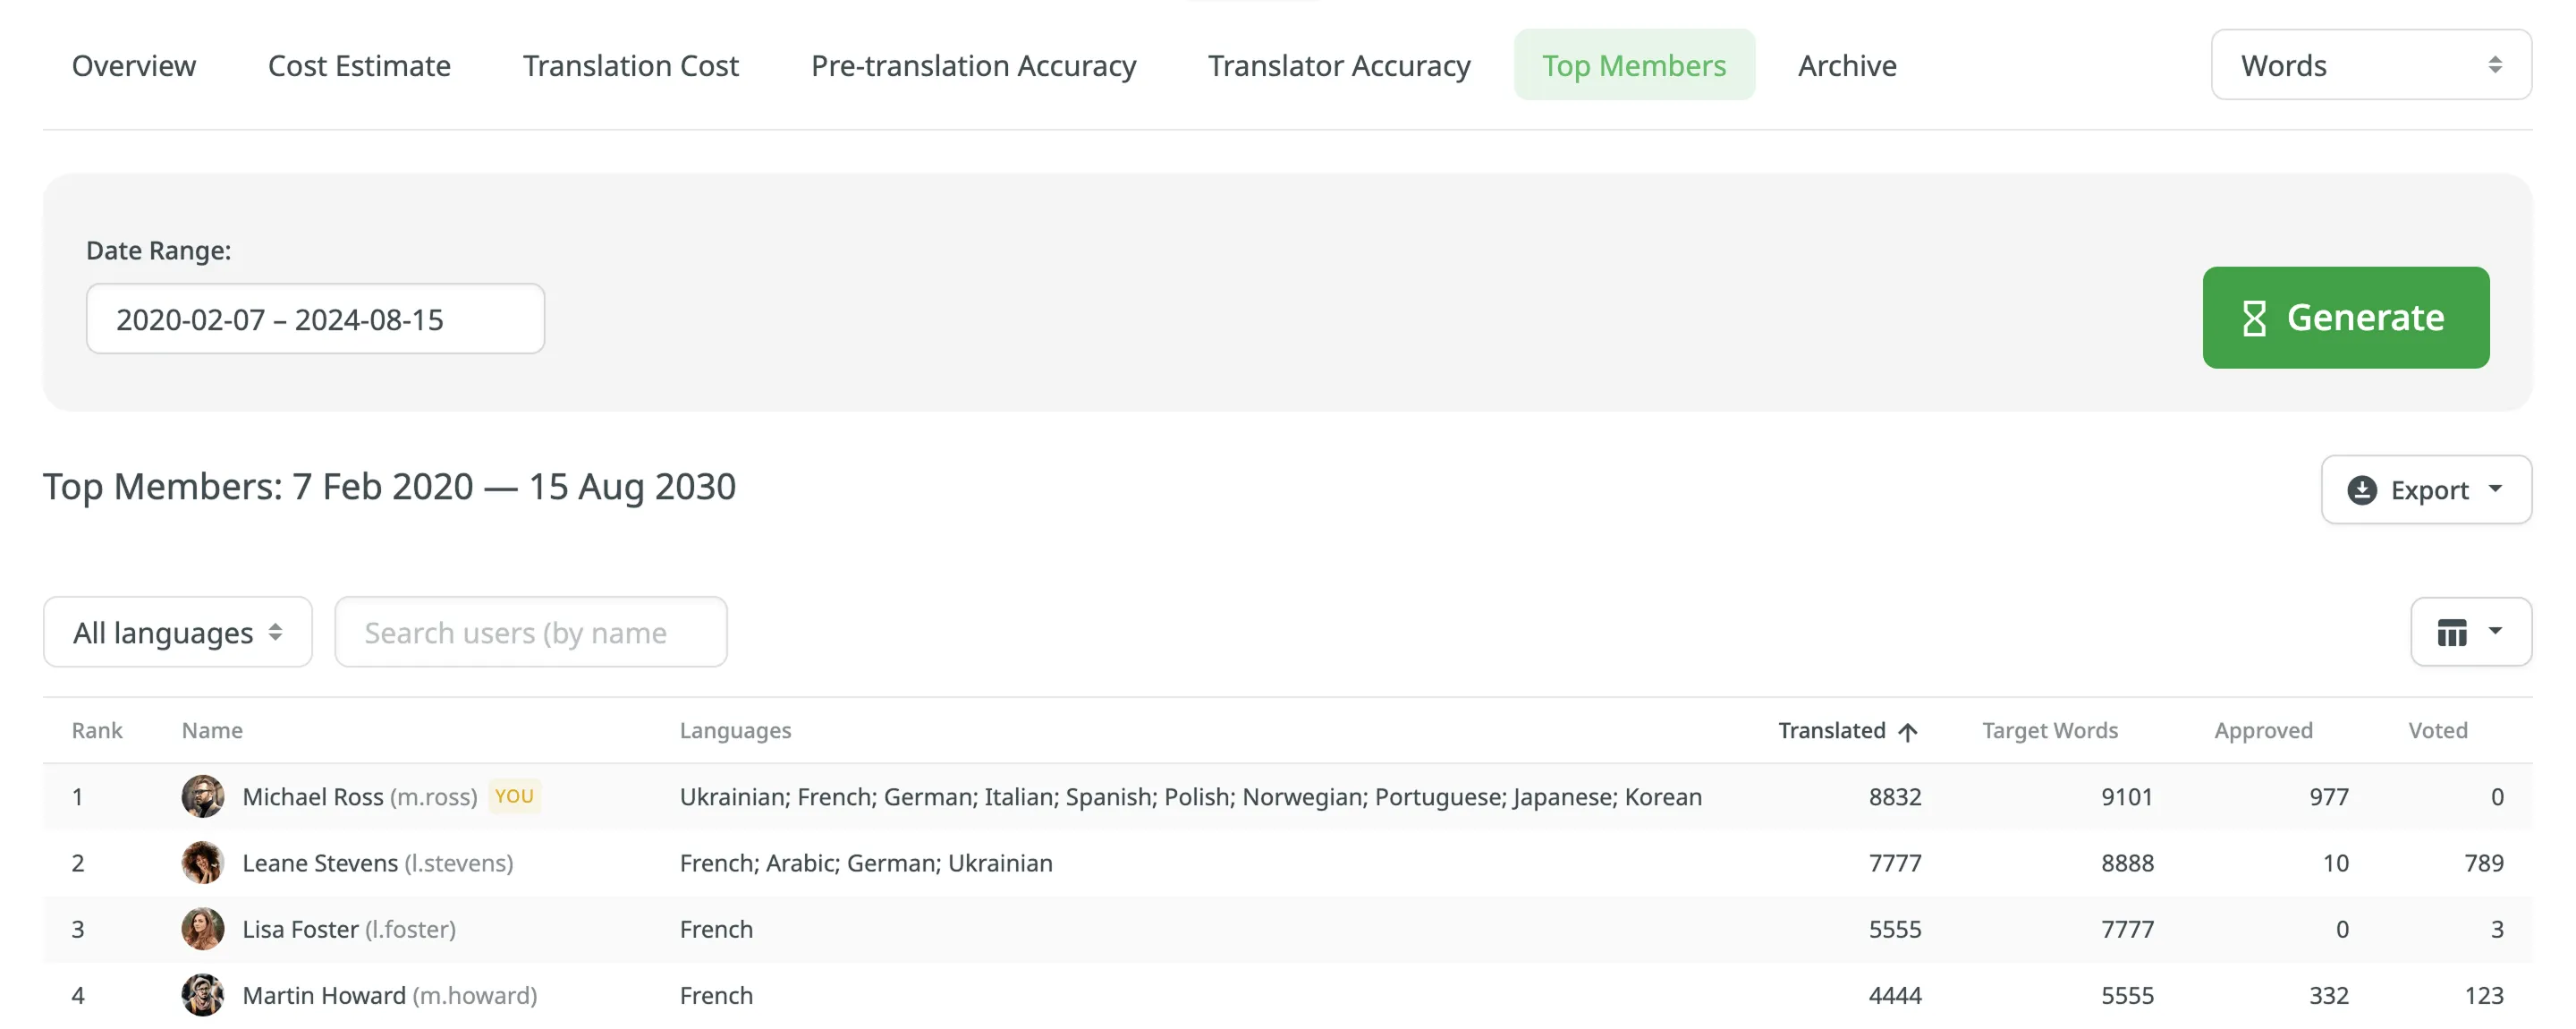
Der Bericht „Top-Mitglieder“ zeigt dir, wer im Laufe der Zeit am meisten zu den Übersetzungen deines Projekts beigetragen hat. Diese Liste enthält alle Benutzer, die jemals einen Beitrag geleistet haben, auch wenn sie keine aktuellen Projektmitglieder mehr sind.
Standardparameter:
- Inhaltseinheit: Wörter
- Zeitraum: Letzte 30 Tage
- Sortiert nach: übersetzten Inhaltseinheiten. Das Mitglied mit den meisten Übersetzungen steht oben in der Liste.
- Sprachen: alle Sprachen
- Mitwirkende: alle
Das Label YOU wird neben deinem Benutzernamen in der Berichtstabelle angezeigt, sodass du deinen persönlichen Beitrag leichter erkennen kannst.
Sortiere die Mitglieder neu, indem du auf den gewünschten Parameter klickst. Wenn du beispielsweise Mitglieder anhand ihrer Korrekturleseaktivität analysieren möchtest, klicke auf den Parameter Genehmigt, um die Sortierung neu durchzuführen.
Benutzerdefinierte Liste der Top-Mitglieder erstellen
Abschnitt betitelt „Benutzerdefinierte Liste der Top-Mitglieder erstellen“Um eine benutzerdefinierte Liste der Top-Mitglieder zu erstellen, gehe wie folgt vor:
- Wähle die gewünschte Berichtseinheit aus (Wörter, Strings, Zeichen mit oder ohne Leerzeichen).
- Wähle den Zeitraum aus, für den du die Aktivität der Mitwirkenden anzeigen möchtest.
- Um eine Liste der Mitwirkenden für eine bestimmte Sprache zu erstellen, wähle die gewünschte Sprache aus dem Dropdown-Menü über der Liste aus. Alternativ kannst du Alle Sprachen auswählen.
- Klicke auf Generieren.
Um ein bestimmtes Mitglied zu finden, verwende das Suchfeld. Um die Profilseite des Mitglieds zu öffnen, doppelklicke auf den Namen.
Die Liste der Top-Mitglieder enthält die folgenden Spalten:
- Rang – Position des Mitwirkenden in der Liste basierend auf den aktuell ausgewählten Sortierkriterien (z. B. Übersetzt, Genehmigt usw.).
- Name – Vorname, Nachname und Benutzername des Mitwirkenden.
- Sprachen – Projektsprache(n).
- Übersetzt – Anzahl der übersetzten Inhaltseinheiten des Ausgangsinhalts.
- Zielwörter – Anzahl der übersetzten Inhaltseinheiten in einer Zielsprache.
Dieser Parameter ist für die Inhaltseinheit Strings nicht verfügbar, da die Anzahl der Ausgangs- und übersetzten Strings immer gleich ist. - Genehmigt – Anzahl der genehmigten Inhaltseinheiten.
- Abgegeben – die Anzahl der von einem Mitwirkenden abgegebenen Stimmen.
- „+“-Stimmen erhalten – die Anzahl der positiven Stimmen, die ein Mitwirkender für Übersetzungen erhalten hat.
- „-“-Stimmen erhalten – die Anzahl der negativen Stimmen, die ein Mitwirkender für Übersetzungen erhalten hat.
- Gewonnen – die Anzahl der Genehmigungen, die ein Mitwirkender für Übersetzungen erhalten hat.
- Um den Bericht „Top-Mitglieder“ herunterzuladen, klicke auf Exportieren und wähle das gewünschte Exportformat (CSV, XLSX oder JSON).
Um die Sichtbarkeit der Spalten im Bericht anzupassen, klicke oben rechts in der Tabelle auf und wähle die gewünschten Spalten aus.
Um den Bericht „Top-Mitglieder“ herunterzuladen, klicke auf Exportieren und wähle das gewünschte Exportformat (CSV, XLSX oder JSON).
Der Bereich „Archiv“ ermöglicht dir den Zugriff auf Datensätze zuvor erstellter Berichte zur Kostenschätzung und zu den Übersetzungskosten und bietet eine praktische Möglichkeit, historische Daten zu überprüfen.
In diesem Bereich entfällt außerdem die Notwendigkeit, auf den Abschluss der Berichtserstellung zu warten. Du kannst die Erstellung eines Berichts starten und später darauf zurückkommen. Im Archiv kannst du die Berichtszusammenfassung überprüfen und sie bei Bedarf in verschiedenen unterstützten Dateiformaten herunterladen.
Jedes Projekt verfügt über einen eigenen unabhängigen Archivbereich mit zuvor erstellten Berichten, die nur Projektmitgliedern mit Manager-Berechtigungen (oder höher) zur Verfügung stehen.
Von Übersetzern anhand ihrer Beiträge erstellte Berichte werden nicht zum Archiv hinzugefügt.
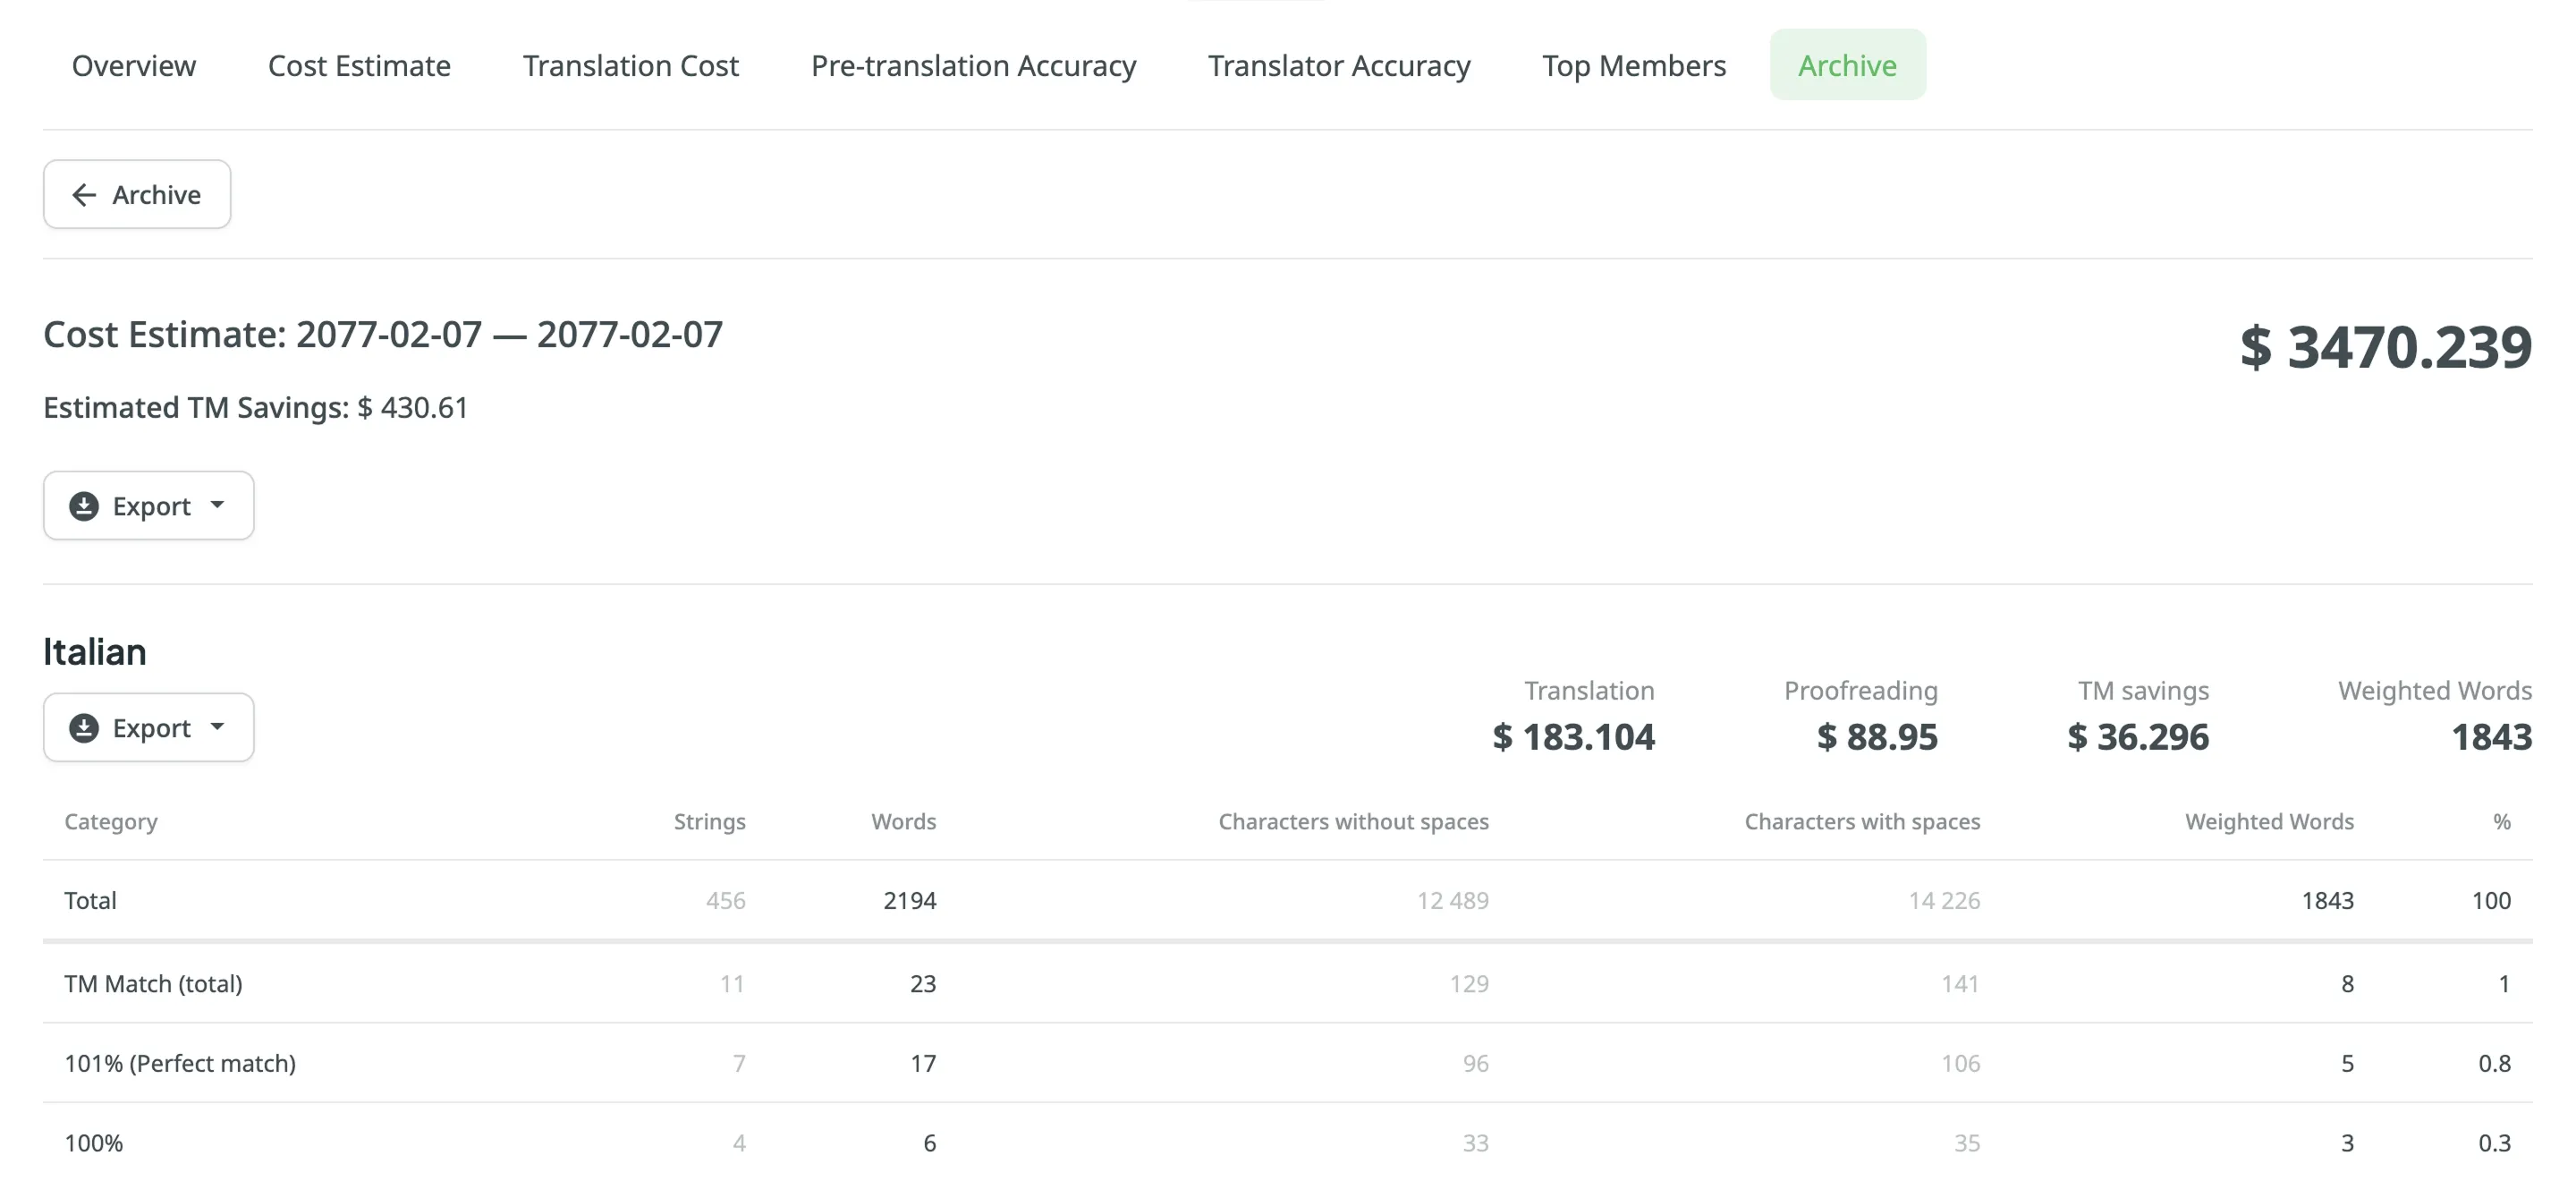
Um die Zusammenfassung der zuvor erstellten Berichte (d. h. Archivdatensätze) anzuzeigen, gehe wie folgt vor:
- Öffne dein Projekt und gehe zu Berichte > Archiv.
- Klicke auf den Namen des gewünschten Archivdatensatzes.
- Nachdem du den Archivdatensatz des Berichts geöffnet hast, kannst du alle benötigten Daten anzeigen.
Um zuvor erstellte Berichte zu exportieren, gehe wie folgt vor:
- Öffne dein Projekt und gehe zu Berichte > Archiv.
- Klicke in der Liste auf den gewünschten Bericht und dann auf .
- Klicke auf das gewünschte Dateiformat für den Export.
Um zuvor erstellte Berichte zu löschen, gehe wie folgt vor:
- Öffne dein Projekt und gehe zu Berichte > Archiv.
- Klicke in der Liste auf den gewünschten Bericht und dann auf .
- Klicke auf Löschen.